"Agent của mình mất 45 giây để trả lời câu hỏi 'Đà Lạt hôm nay thế nào?'. Không biết lỗi ở model, ở tool, hay ở đâu." — Câu này mình nghe từ không ít anh em đang build AI Agent. Và câu trả lời thường là: đoán mò, rồi đổi model, rồi tinh chỉnh prompt, rồi vẫn chậm.
Bài này mình sẽ chỉ cách dùng OpenTelemetry để không phải đoán nữa. Nhìn vào một cái dashboard là biết ngay lỗi nằm ở tầng nào, mất bao nhiêu giây ở bước nào, và dữ liệu đầu vào của model có đúng không.
Mình sẽ demo bằng Python (FastAPI + OpenAI SDK), viết tay từng span để bạn hiểu rõ cơ chế — không phải magic box auto-instrument.
Vấn đề: tại sao print() không đủ để debug AI Agent?
Khi build một ứng dụng web thông thường, print() hay structured log là đủ.
Nhưng AI Agent không phải là một hàm đơn — nó là một chuỗi nhiều tầng lồng nhau:
User request
  → LLM call lần 1 (gpt-4o-mini đọc câu hỏi, quyết định cần tool gì)
      → finish_reason = "tool_calls" → model muốn gọi tool
          → execute_tool get_weather(city="Đà Lạt")   ← có thể chậm ở đây
          → execute_tool search_flights(origin=...)    ← hoặc ở đây
      → LLM call lần 2 (tổng hợp kết quả tool → câu trả lời cuối)
  → Response trả về user
Khi Agent chậm hoặc trả lời sai, nguyên nhân có thể nằm ở bất kỳ tầng nào:
| Tầng | Câu hỏi cần trả lời | Ví dụ triệu chứng |
|---|---|---|
| LLM Call | Model chậm? Bị cắt cụt? Sai model? | Câu trả lời thiếu, finish_reason=length |
| Tool Call | API ngoài timeout? Trả sai dữ liệu? | Agent nói Đà Lạt 35°C dù thực tế 18°C |
| Orchestration | Agent lặp vòng? Gọi tool thừa? | 1 request tốn 8 lần gọi LLM thay vì 2 |
Giờ thử tưởng tượng bạn debug với print():
# Cách debug "dân gian" — mình đã từng làm đúng kiểu này
print(f"Gọi LLM lần 1...")
t0 = time.time()
response = client.chat.completions.create(...)
print(f"LLM xong: {time.time() - t0:.2f}s")

print(f"Gọi tool get_weather...")
t1 = time.time()
result = get_weather(city)
print(f"Tool xong: {time.time() - t1:.2f}s")
Output trong terminal:
Gọi LLM lần 1...
LLM xong: 0.62s
Gọi tool get_weather...
Tool xong: 6.10s        ← okay, chậm ở đây
Gọi LLM lần 2...
LLM xong: 0.91s
Với Agent đơn giản 2 bước thì okay, nhưng khi Agent có 5-10 tool, retry logic, multi-step planning, parallel tool calls... bạn phải:
- Tự
time.time()ở khắp nơi trong codebase - Tự tạo correlation ID để ghép log của cùng 1 request
- Tự tính tổng thời gian từng tầng
- Không có cách nào so sánh request này với request trước một cách trực quan
- Khi deploy production, log sẽ đến từ nhiều process/pod — ghép lại càng khó hơn
Đây chính xác là bài toán mà Distributed Tracing ra đời để giải quyết — và OpenTelemetry là chuẩn mở để làm điều đó.
OpenTelemetry và GenAI Semantic Conventions — nền tảng cần biết
OpenTelemetry là gì?
OpenTelemetry (OTel) là một dự án của CNCF (Cloud Native Computing Foundation) — nơi Google, Microsoft, AWS, Datadog và hàng chục công ty khác cùng đóng góp. Nó định nghĩa:
- API — interface chuẩn để instrument code (tạo span, gắn attribute...)
- SDK — implementation cho từng ngôn ngữ (Python, Go, Java, JS...)
- OTLP — giao thức truyền tải telemetry data (OpenTelemetry Protocol)
- Semantic Conventions — quy ước đặt tên attribute để mọi công cụ hiểu nhau
OTel thu thập 3 loại tín hiệu:
| Tín hiệu | Dùng để | Ví dụ AI Agent |
|---|---|---|
| Trace | Theo dõi 1 request đầu đến cuối, đo thời gian từng bước | Debug "tại sao request này chậm 8 giây?" |
| Metric | Số liệu tổng hợp theo thời gian | "Trung bình mỗi request tốn bao nhiêu token?" |
| Log | Sự kiện rời rạc có timestamp | "Lỗi gì xảy ra lúc 14:32:05?" |
Bài này sẽ tập trung vào Trace — thứ hữu ích nhất để debug AI Agent.
OTLP — giao thức gửi dữ liệu đi đâu cũng được
Điểm mạnh lớn nhất của OTel là vendor-neutral. App của bạn chỉ cần nói ngôn ngữ OTLP — rồi muốn gửi đến đâu cũng được:
App (Python + OTel SDK)
  │  OTLP gRPC :4317 / HTTP :4318
  ▼
┌──────────────────────────────────────────────┐
│  Aspire Dashboard   — dev local, 1 docker run│
│  Jaeger             — self-hosted, miễn phí  │
│  Grafana + Tempo    — production stack       │
│  Datadog / New Relic — cloud, có GenAI view  │
└──────────────────────────────────────────────┘
Muốn đổi từ Aspire Dashboard sang Datadog? Chỉ đổi biến môi trường OTEL_EXPORTER_OTLP_ENDPOINT. Không sửa một dòng code app.
GenAI Semantic Conventions
Nếu OTel là "chuẩn chung cho observability", thì GenAI Semantic Conventions là "chuẩn con dành riêng cho AI/LLM". Nó định nghĩa tên span và attribute chuẩn cho model, agent, và tool.
Thay vì mỗi team tự đặt tên theo ý mình:
# Team A
span.set_attribute("model_name", "gpt-4o-mini")
span.set_attribute("tokens_in", 142)

# Team B
span.set_attribute("llm.model", "gpt-4o-mini")
span.set_attribute("prompt_tokens", 142)
Tất cả đều dùng gen_ai.*:
# Chuẩn GenAI Semantic Conventions — mọi tool đều hiểu
span.set_attribute("gen_ai.request.model", "gpt-4o-mini")
span.set_attribute("gen_ai.usage.input_tokens", 142)
Kết quả: Datadog, Grafana, Aspire Dashboard đều hiển thị đúng — không cần cấu hình gì thêm.
3 nhóm span chính:
| Nhóm | gen_ai.operation.name |
Tên span | Khi nào dùng |
|---|---|---|---|
| Agent | invoke_agent |
invoke_agent {agent_name} |
Bọc toàn bộ 1 lượt xử lý |
| Inference | chat |
chat {model} |
1 lần gọi LLM |
| Tool | execute_tool |
execute_tool {tool_name} |
1 lần thực thi tool |
Các attribute quan trọng nhất cần biết
Trước khi vào code, mình tổng hợp các gen_ai.* hay dùng nhất — đây là thứ bạn sẽ nhìn vào mỗi khi debug:
Trên span chat (LLM call)
| Attribute | Ý nghĩa | Debug use case |
|---|---|---|
gen_ai.provider.name |
openai, anthropic, aws.bedrock... |
So sánh latency giữa provider |
gen_ai.request.model |
Model bạn yêu cầu | Đảm bảo đúng model |
gen_ai.response.model |
Model thực tế trả lời | Phát hiện provider auto-fallback |
gen_ai.usage.input_tokens |
Số token prompt | Phát hiện prompt "ăn" quá nhiều token |
gen_ai.usage.output_tokens |
Số token response | Ước tính chi phí |
gen_ai.response.finish_reasons |
stop / tool_calls / length |
length = câu trả lời bị cắt cụt! |
finish_reasons=["length"] là một trong những lỗi phổ biến nhất — Agent trả lời thiếu, bị cắt giữa câu, mà dev cứ nghĩ do model không hiểu prompt. Thực ra chỉ cần tăng max_tokens.
Trên span execute_tool (tool call)
| Attribute | Ý nghĩa | Debug use case |
|---|---|---|
gen_ai.tool.name |
Tên tool được gọi | Biết tool nào đang chậm |
gen_ai.tool.call.id |
ID khớp với request của model | Nối "model yêu cầu gì" với "tool trả gì" |
gen_ai.tool.call.arguments (opt-in) |
Tham số model truyền vào | Model có parse đúng intent không? |
gen_ai.tool.call.result (opt-in) |
Kết quả tool trả về | Dữ liệu đầu vào của LLM có đúng không? |
Demo thực tế: instrument Travel Agent từng bước
Mình sẽ build một Travel Agent — nhận câu hỏi về thời tiết và chuyến bay, gọi OpenAI, gọi tool, rồi trả lời. Toàn bộ code chạy được ngay.
Setup môi trường
pip install openai fastapi uvicorn python-dotenv \
    opentelemetry-api==1.27.0 \
    opentelemetry-sdk==1.27.0 \
    opentelemetry-exporter-otlp==1.27.0 \
    opentelemetry-instrumentation-fastapi==0.48b0 \
    httpx==0.27.2   # pin version tránh conflict với openai SDK
Tạo file .env:
OPENAI_API_KEY=sk-your-key-here
OPENAI_MODEL=gpt-4o-mini
OTEL_EXPORTER_OTLP_ENDPOINT=http://localhost:4317
OTEL_SERVICE_NAME=travel-agent

# Bật để xem nội dung prompt/response trong trace (chỉ dùng khi dev!)
OTEL_GENAI_CAPTURE_CONTENT=true

# Cờ để giả lập lỗi khi muốn test
SIMULATE_SLOW_TOOL=false
SIMULATE_WRONG_DATA=false
Khởi động Aspire Dashboard — không cần tài khoản cloud, không cần config gì:
docker run -d \
  --name aspire-dashboard \
  -p 18888:18888 \
  -p 4317:18889 \
  -e ASPIRE_DASHBOARD_UNSECURED_ALLOW_ANONYMOUS=true \
  mcr.microsoft.com/dotnet/aspire-dashboard:latest
Mở http://localhost:18888 — dashboard đang chờ nhận trace.
Bước 1 — Khởi tạo OTel SDK
# otel_genai.py
import os, time, json, contextlib
from typing import Any

from opentelemetry import trace
from opentelemetry.sdk.resources import Resource
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.sdk.trace.export import BatchSpanProcessor
from opentelemetry.exporter.otlp.proto.grpc.trace_exporter import OTLPSpanExporter
from opentelemetry.trace import SpanKind, Status, StatusCode

CAPTURE_CONTENT = os.getenv("OTEL_GENAI_CAPTURE_CONTENT", "false").lower() == "true"
OTLP_ENDPOINT   = os.getenv("OTEL_EXPORTER_OTLP_ENDPOINT", "http://localhost:4317")
SERVICE_NAME     = os.getenv("OTEL_SERVICE_NAME", "travel-agent")


def setup_tracing() -> trace.Tracer:
    resource = Resource.create({
        "service.name": SERVICE_NAME,
        "service.version": "1.0.0",
    })
    provider = TracerProvider(resource=resource)

    exporter = OTLPSpanExporter(endpoint=OTLP_ENDPOINT, insecure=True)

    # BatchSpanProcessor: gom span gửi theo lô, async — overhead < 1ms/span
    # Dùng SimpleSpanProcessor nếu muốn gửi ngay (chỉ khi debug OTel)
    provider.add_span_processor(BatchSpanProcessor(exporter))
    trace.set_tracer_provider(provider)

    return trace.get_tracer(SERVICE_NAME)


tracer = setup_tracing()  # chạy 1 lần khi module được import
BatchSpanProcessor là lý do OTel không làm chậm app — nó buffer span trong memory, gom lại gửi theo lô mỗi vài giây. Nếu dùng SimpleSpanProcessor (gửi ngay từng span) thì mỗi request phải chờ network round-trip đến collector — rất tốn latency.
Bước 2 — Tạo 3 context manager cho 3 loại span
Đây là phần lõi. Mình dùng @contextlib.contextmanager để wrap span, Python
tự đóng span khi thoát khỏi with block — kể cả khi có exception:
# ── SPAN 1: invoke_agent ──────────────────────────────────────────────────────
@contextlib.contextmanager
def traced_agent(agent_name: str, user_message: str):
    """Span cha bọc toàn bộ 1 lượt xử lý của Agent."""
    with tracer.start_as_current_span(
        f"invoke_agent {agent_name}",
        kind=SpanKind.INTERNAL,  # INTERNAL: xử lý trong tiến trình
    ) as span:
        span.set_attribute("gen_ai.operation.name", "invoke_agent")
        span.set_attribute("gen_ai.agent.name", agent_name)
        if CAPTURE_CONTENT:
            span.set_attribute("gen_ai.input.messages",
                json.dumps([{"role": "user", "content": user_message}]))
        try:
            yield span
            span.set_status(Status(StatusCode.OK))
        except Exception as e:
            span.set_status(Status(StatusCode.ERROR, str(e)))
            span.set_attribute("error.type", type(e).__name__)
            raise


# ── SPAN 2: chat ──────────────────────────────────────────────────────────────
@contextlib.contextmanager
def traced_chat_call(provider: str, model: str, messages: list[dict]):
    """Span bọc 1 lần gọi LLM. Gắn request attribute trước, response sau."""
    start = time.time()
    with tracer.start_as_current_span(
        f"chat {model}",
        kind=SpanKind.CLIENT,   # CLIENT: gọi ra ngoài qua network
    ) as span:
        # Gắn request attribute TRƯỚC khi gọi API
        span.set_attribute("gen_ai.operation.name", "chat")
        span.set_attribute("gen_ai.provider.name", provider)
        span.set_attribute("gen_ai.request.model", model)
        if CAPTURE_CONTENT:
            span.set_attribute("gen_ai.input.messages", json.dumps(messages))

        ctx: dict[str, Any] = {"span": span, "start": start}
        try:
            yield ctx
            span.set_status(Status(StatusCode.OK))
        except Exception as e:
            span.set_status(Status(StatusCode.ERROR, str(e)))
            span.set_attribute("error.type", type(e).__name__)
            raise
        finally:
            span.set_attribute("gen_ai.client.operation.duration_s",
                round(time.time() - start, 3))


def record_chat_response(ctx: dict, response) -> None:
    """Gắn response attribute vào span SAU KHI nhận được từ LLM.

    Tách riêng vì token count, finish_reason, response model... chỉ có
    sau khi API trả về — không thể gắn trước khi gọi.
    """
    span = ctx["span"]
    span.set_attribute("gen_ai.response.model", response.model)
    span.set_attribute("gen_ai.response.id", response.id)
    span.set_attribute("gen_ai.usage.input_tokens", response.usage.prompt_tokens)
    span.set_attribute("gen_ai.usage.output_tokens", response.usage.completion_tokens)
    span.set_attribute("gen_ai.response.finish_reasons",
        [c.finish_reason for c in response.choices])

    if CAPTURE_CONTENT:
        output = []
        for choice in response.choices:
            msg = {"role": choice.message.role, "content": choice.message.content}
            if choice.message.tool_calls:
                msg["tool_calls"] = [
                    {"id": tc.id, "name": tc.function.name,
                     "arguments": tc.function.arguments}
                    for tc in choice.message.tool_calls
                ]
            output.append(msg)
        span.set_attribute("gen_ai.output.messages", json.dumps(output))


# ── SPAN 3: execute_tool ──────────────────────────────────────────────────────
@contextlib.contextmanager
def traced_tool_call(tool_name: str, tool_call_id: str, arguments: dict):
    """Span bọc 1 lần thực thi tool. Duration đo riêng, tách biệt khỏi span chat."""
    start = time.time()
    with tracer.start_as_current_span(
        f"execute_tool {tool_name}",
        kind=SpanKind.INTERNAL,
    ) as span:
        span.set_attribute("gen_ai.operation.name", "execute_tool")
        span.set_attribute("gen_ai.tool.name", tool_name)
        span.set_attribute("gen_ai.tool.call.id", tool_call_id)
        if CAPTURE_CONTENT:
            span.set_attribute("gen_ai.tool.call.arguments",
                json.dumps(arguments))

        ctx: dict[str, Any] = {"span": span}
        try:
            yield ctx
            span.set_status(Status(StatusCode.OK))
        except Exception as e:
            span.set_status(Status(StatusCode.ERROR, str(e)))
            span.set_attribute("error.type", type(e).__name__)
            raise
        finally:
            span.set_attribute("gen_ai.client.operation.duration_s",
                round(time.time() - start, 3))


def record_tool_result(ctx: dict, result: Any) -> None:
    if CAPTURE_CONTENT:
        ctx["span"].set_attribute("gen_ai.tool.call.result",
            json.dumps(result, default=str))
Tại sao OTel tự biết span nào là cha/con? Vì start_as_current_span() lưu span hiện tại vào context thread-local của Python. Khi bạn tạo span mới bên trong with của span cha, OTel SDK đọc context đó và tự set parent_id. Không cần truyền gì thủ công.
Bước 3 — Tool definitions và tool functions
# tools.py
import os, time, random

# Cờ để giả lập 2 tình huống lỗi kinh điển — rất hữu ích để demo/test
SIMULATE_SLOW_TOOL  = os.getenv("SIMULATE_SLOW_TOOL", "false").lower() == "true"
SIMULATE_WRONG_DATA = os.getenv("SIMULATE_WRONG_DATA", "false").lower() == "true"


def get_weather(city: str) -> dict:
    if SIMULATE_SLOW_TOOL:
        time.sleep(6)   # giả lập API thời tiết bên ngoài bị nghẽn mạng

    weather_db = {
        "đà nẵng": {"temp_c": 31, "condition": "Nắng nhẹ"},
        "hà nội":  {"temp_c": 24, "condition": "Nhiều mây"},
        "đà lạt":  {"temp_c": 18, "condition": "Mát mẻ, có sương"},
    }
    data = weather_db.get(city.strip().lower(), {"temp_c": 27, "condition": "N/A"})

    if SIMULATE_WRONG_DATA and city.strip().lower() == "đà lạt":
        data = {"temp_c": 35, "condition": "Nắng nóng"}  # sai có chủ đích để demo

    return {"city": city, **data}


def search_flights(origin: str, destination: str) -> dict:
    time.sleep(random.uniform(0.2, 0.5))  # độ trễ thực tế nhỏ, bình thường
    base = random.randint(800_000, 2_500_000)
    return {
        "origin": origin, "destination": destination,
        "flights": [
            {"airline": "VietJet", "price_vnd": base, "duration_min": 75},
            {"airline": "Vietnam Airlines", "price_vnd": base + 350_000, "duration_min": 70},
        ],
    }


TOOL_DEFINITIONS = [
    {"type": "function", "function": {
        "name": "get_weather",
        "description": "Lấy thời tiết hiện tại của một thành phố Việt Nam",
        "parameters": {"type": "object",
            "properties": {"city": {"type": "string"}},
            "required": ["city"]},
    }},
    {"type": "function", "function": {
        "name": "search_flights",
        "description": "Tìm chuyến bay giữa 2 thành phố",
        "parameters": {"type": "object",
            "properties": {
                "origin": {"type": "string"},
                "destination": {"type": "string"},
            },
            "required": ["origin", "destination"]},
    }},
]

TOOL_FUNCTIONS = {"get_weather": get_weather, "search_flights": search_flights}
Bước 4 — Agent loop với span đầy đủ
# agent.py
import json
from openai import OpenAI
from otel_genai import (
    traced_agent, traced_chat_call, record_chat_response,
    traced_tool_call, record_tool_result, CAPTURE_CONTENT,
)
from tools import TOOL_DEFINITIONS, TOOL_FUNCTIONS

client = OpenAI()
MODEL  = "gpt-4o-mini"

SYSTEM_PROMPT = (
    "Bạn là trợ lý du lịch. Khi cần thông tin thời tiết hoặc chuyến bay, "
    "hãy dùng tool — đừng tự đoán. Trả lời ngắn gọn, tiếng Việt."
)


def run_agent(user_message: str) -> str:
    with traced_agent("travel-agent", user_message):   # span cha

        messages = [
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user",   "content": user_message},
        ]

        # LLM lần 1: model đọc câu hỏi → quyết định gọi tool nào
        with traced_chat_call("openai", MODEL, messages) as ctx:
            response = client.chat.completions.create(
                model=MODEL,
                messages=messages,
                tools=TOOL_DEFINITIONS,
            )
            record_chat_response(ctx, response)

        choice = response.choices[0]
        messages.append(choice.message.model_dump(exclude_none=True))

        # Mỗi tool call của model → 1 span execute_tool riêng biệt
        if choice.finish_reason == "tool_calls":
            for tc in choice.message.tool_calls:
                args = json.loads(tc.function.arguments)

                with traced_tool_call(tc.function.name, tc.id, args) as tool_ctx:
                    result = TOOL_FUNCTIONS[tc.function.name](**args)
                    record_tool_result(tool_ctx, result)

                messages.append({
                    "role": "tool",
                    "tool_call_id": tc.id,
                    "content": json.dumps(result, ensure_ascii=False),
                })

            # LLM lần 2: tổng hợp kết quả tool → câu trả lời cuối
            with traced_chat_call("openai", MODEL, messages) as ctx:
                response = client.chat.completions.create(
                    model=MODEL, messages=messages
                )
                record_chat_response(ctx, response)

        return response.choices[0].message.content
Bước 5 — Expose qua FastAPI
# main.py
from fastapi import FastAPI
from pydantic import BaseModel
from opentelemetry.instrumentation.fastapi import FastAPIInstrumentor
from agent import run_agent

app = FastAPI()
FastAPIInstrumentor.instrument_app(app)  # 1 dòng này tự tạo span HTTP cho mọi route

class AskRequest(BaseModel):
    message: str

@app.post("/ask")
def ask(req: AskRequest):
    return {"answer": run_agent(req.message)}
FastAPIInstrumentor tự tạo span POST /ask bao bên ngoài span invoke_agent — nên trên dashboard bạn thấy cả overhead HTTP, không chỉ phần AI.
Chạy thử:
uvicorn main:app --reload --port 8000

curl -X POST http://localhost:8000/ask \
  -H "Content-Type: application/json" \
  -d '{"message": "Đà Nẵng hôm nay thế nào, có chuyến bay tới Hà Nội không?"}'
Đọc trace trên Aspire Dashboard
Giao diện tổng thể:
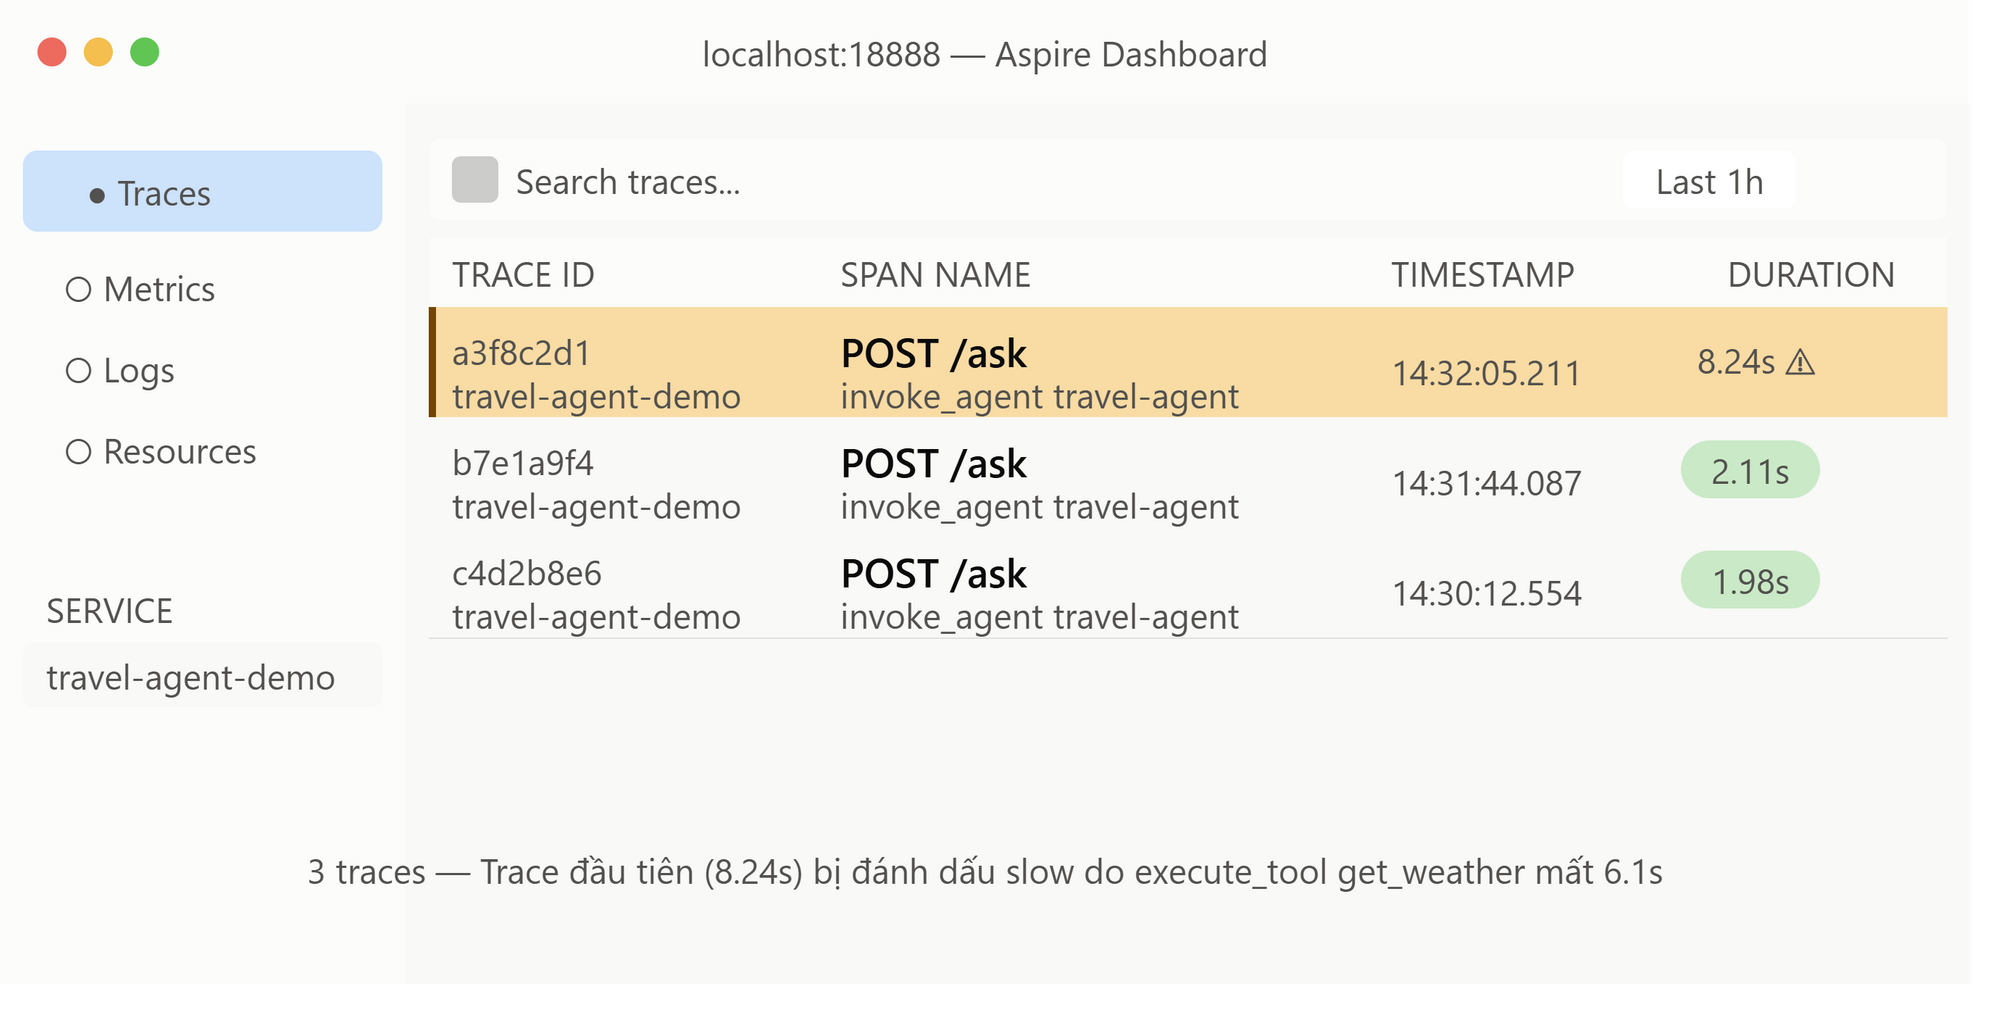
Sau khi gửi request, mở http://localhost:18888 → tab Traces → click vào trace mới nhất. Bạn sẽ thấy cây span kiểu này:
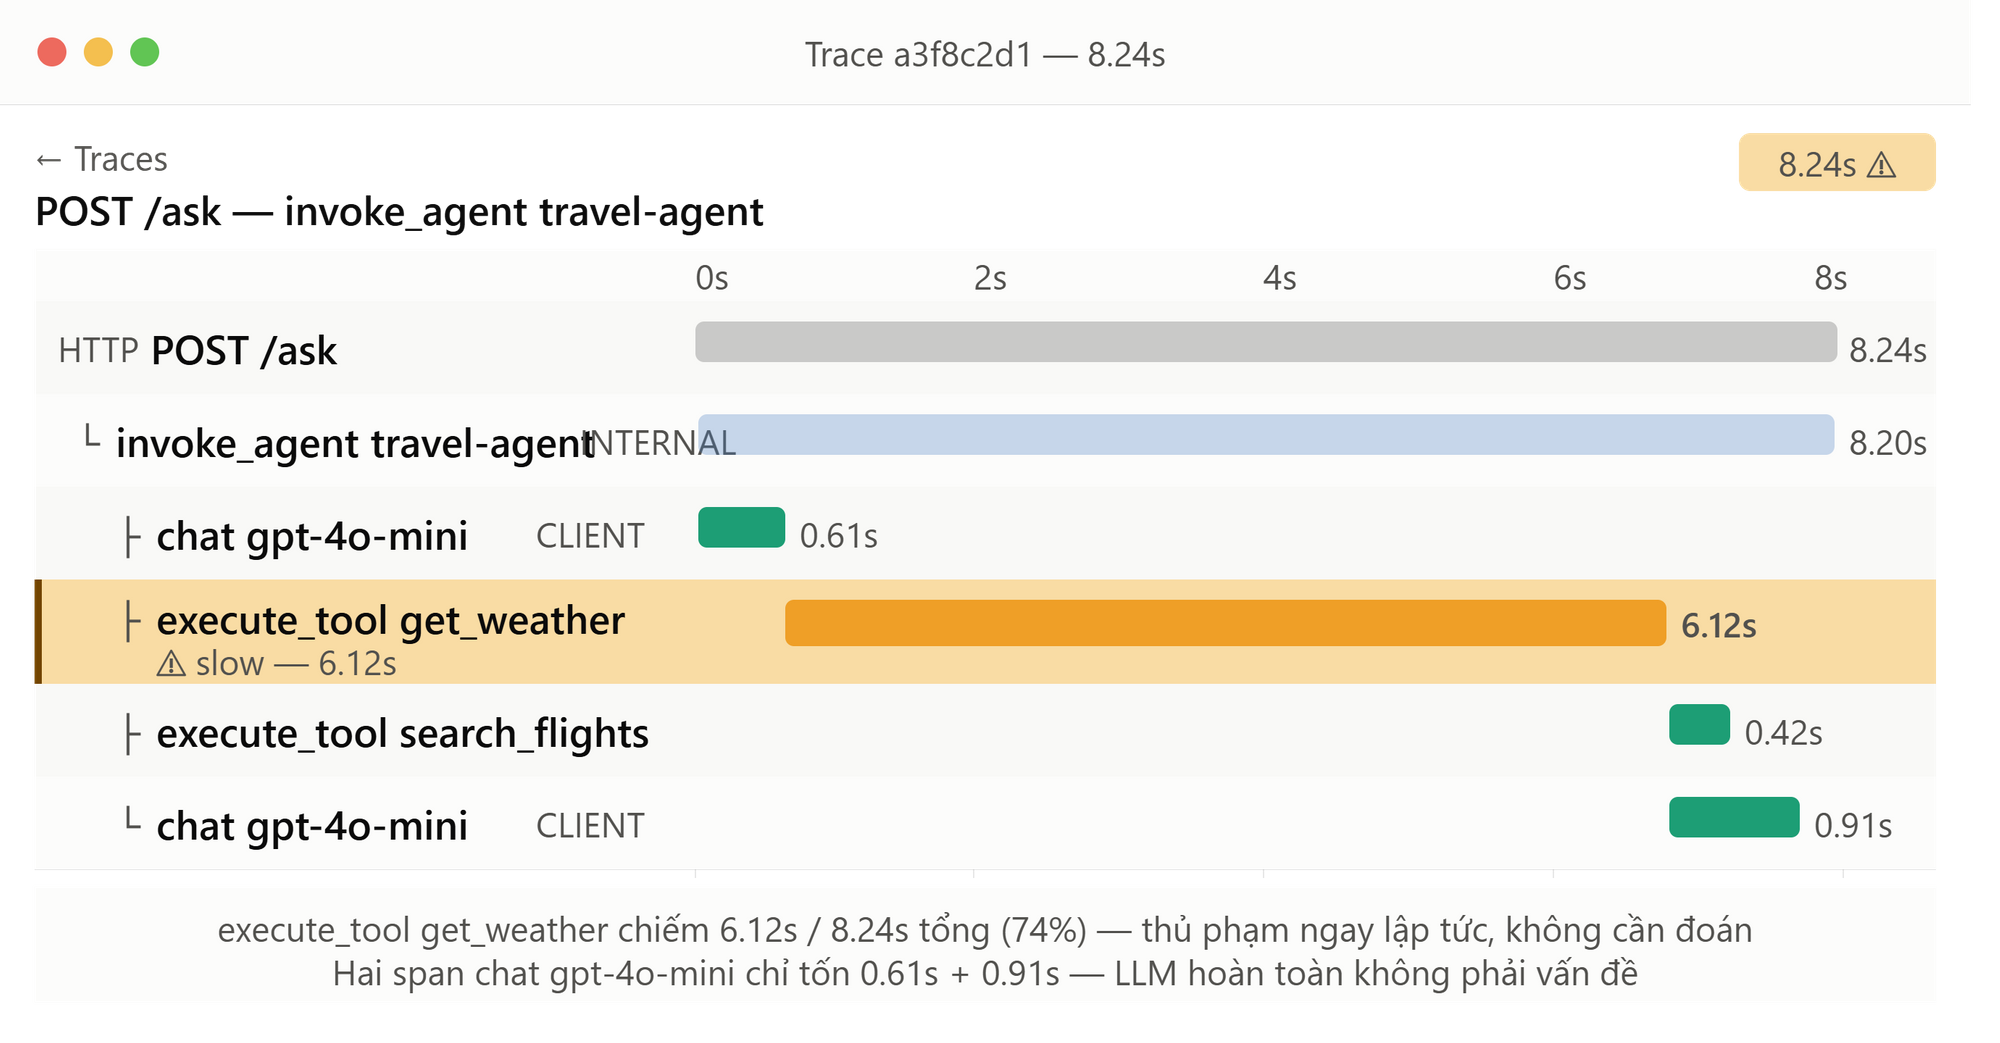
Phân tích tình huống 1: Agent phản hồi CHẬM
Cài SIMULATE_SLOW_TOOL=true rồi restart server, gửi lại request:
invoke_agent travel-agent   ████████████████████████████████  8.2s
├── chat gpt-4o-mini        ██  0.6s
├── execute_tool get_weather ████████████████████████  6.1s  ← thủ phạm
├── execute_tool search_flights  █  0.4s
└── chat gpt-4o-mini        ███  0.9s
Nhìn vào timeline là biết ngay: tool chậm, không phải model chậm. Nếu không có trace, theo mình estimate khoảng 70% anh em sẽ:
- Thử đổi sang
gpt-4o(nhanh hơn nhưng đắt hơn) → không giải quyết gì - Thử giảm độ phức tạp của prompt → cũng không giải quyết gì
- Sau 2 tiếng vò đầu bứt tai mới nghĩ đến việc check API thời tiết bên ngoài
Với trace, mất 5 giây để biết chính xác. Không cần đoán.
Phân tích tình huống 2: Agent trả lời SAI
Cài SIMULATE_WRONG_DATA=true. Agent sẽ trả lời "Đà Lạt nắng nóng 35°C" — sai thực tế. Hầu hết anh em đầu tiên sẽ nghĩ: model ảo giác (hallucination).
Click vào span execute_tool get_weather → panel attribute → xem gen_ai.tool.call.result:
{"city": "Đà Lạt", "temp_c": 35, "condition": "Nắng nóng"}
Dữ liệu đã sai từ tầng tool, trước khi model nhìn vào. Model chỉ đang tổng hợp trung thực dữ liệu sai nó nhận được. Đây không phải hallucination —
đây là garbage in, garbage out.
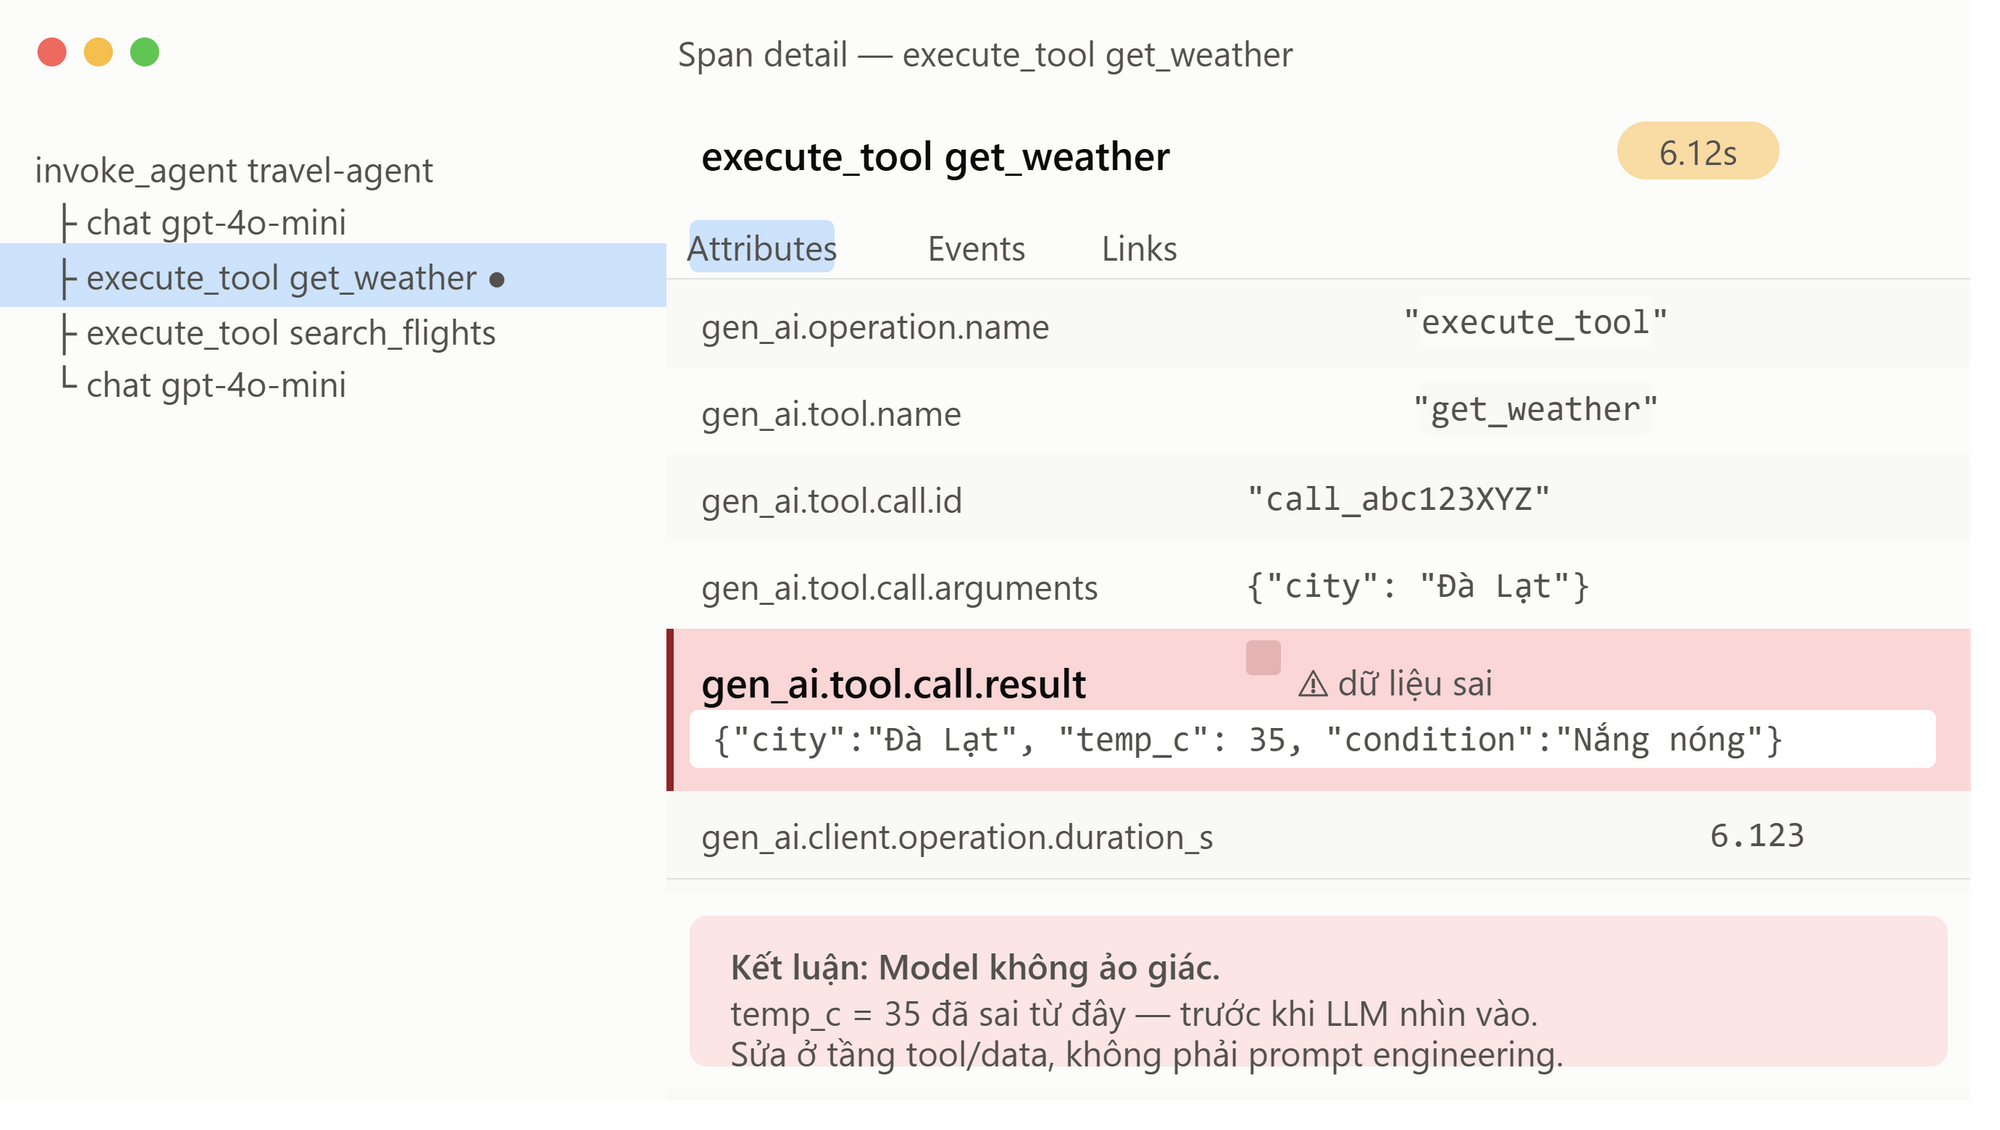
Phân biệt được "AI ảo giác thật" vs "dữ liệu tool sai" quyết định bạn sửa ở tầng nào — rất quan trọng khi bàn với PM hay sếp về nguyên nhân sự cố.
Đọc attribute trên span chat
Click vào span chat gpt-4o-mini đầu tiên:
gen_ai.provider.name           = openai
gen_ai.request.model           = gpt-4o-mini
gen_ai.response.model          = gpt-4o-mini-2024-07-18   ← version thật của OpenAI
gen_ai.usage.input_tokens      = 142
gen_ai.usage.output_tokens     = 38
gen_ai.response.finish_reasons = ["tool_calls"]            ← model muốn gọi tool
gen_ai.client.operation.duration_s = 0.623
gen_ai.request.model vs gen_ai.response.model: hai cái này có thể khác nhau vì OpenAI map alias (gpt-4o-mini) sang version cụ thể. Nếu provider có tính năng auto-fallback khi model quá tải, bạn sẽ thấy ngay ở đây — không cần thêm log nào.
Sơ đồ cây span đầy đủ của 1 request
HTTP POST /ask
└── invoke_agent travel-agent          [INTERNAL]   ~8.2s
    │   gen_ai.operation.name   = "invoke_agent"
    │   gen_ai.agent.name       = "travel-agent"
    │
    ├── chat gpt-4o-mini                [CLIENT]     0.6s
    │       gen_ai.provider.name         = "openai"
    │       gen_ai.request.model         = "gpt-4o-mini"
    │       gen_ai.response.model        = "gpt-4o-mini-2024-07-18"
    │       gen_ai.usage.input_tokens    = 142
    │       gen_ai.usage.output_tokens   = 38
    │       gen_ai.response.finish_reasons = ["tool_calls"]
    │
    ├── execute_tool get_weather        [INTERNAL]   6.1s ⚠️
    │       gen_ai.tool.name             = "get_weather"
    │       gen_ai.tool.call.id          = "call_abc123"
    │       gen_ai.tool.call.arguments   = {"city": "Đà Lạt"}
    │       gen_ai.tool.call.result      = {"temp_c": 18, ...}
    │
    ├── execute_tool search_flights     [INTERNAL]   0.4s
    │       gen_ai.tool.name             = "search_flights"
    │       gen_ai.tool.call.id          = "call_def456"
    │
    └── chat gpt-4o-mini                [CLIENT]     0.9s
            gen_ai.usage.input_tokens    = 387
            gen_ai.usage.output_tokens   = 112
            gen_ai.response.finish_reasons = ["stop"]  ← kết thúc bình thường
Chú ý SpanKind: CLIENT cho lời gọi ra ngoài qua network (LLM API), INTERNAL cho xử lý trong tiến trình. Phân biệt này giúp APM tool tự tính đúng network latency vs compute latency.
Thêm Metrics để nhìn xu hướng dài hạn
Trace giúp debug một request cụ thể. Nhưng nếu muốn biết "trong 1 tuần qua, latency LLM có tăng không?" hay "tổng token tiêu tốn mỗi ngày là bao nhiêu?" — bạn cần Metrics.
# metrics_setup.py
from opentelemetry import metrics
from opentelemetry.sdk.metrics import MeterProvider
from opentelemetry.sdk.metrics.export import PeriodicExportingMetricReader
from opentelemetry.exporter.otlp.proto.grpc.metric_exporter import OTLPMetricExporter

def setup_metrics():
    exporter = OTLPMetricExporter(endpoint=OTLP_ENDPOINT, insecure=True)
    reader = PeriodicExportingMetricReader(exporter, export_interval_millis=10_000)
    provider = MeterProvider(resource=resource, metric_readers=[reader])
    metrics.set_meter_provider(provider)
    return metrics.get_meter(SERVICE_NAME)

meter = setup_metrics()

# 2 metric hay dùng nhất theo GenAI Semantic Conventions
token_histogram = meter.create_histogram(
    name="gen_ai.client.token.usage",
    description="Số token sử dụng mỗi LLM call",
    unit="token",
)
duration_histogram = meter.create_histogram(
    name="gen_ai.client.operation.duration",
    description="Thời gian mỗi LLM call",
    unit="s",
)
Ghi metric sau mỗi LLM call:
def record_chat_response(ctx: dict, response) -> None:
    # ... gắn attribute vào span như trước ...

    # Thêm: ghi metric
    labels = {"gen_ai.provider.name": "openai", "gen_ai.request.model": MODEL}
    token_histogram.record(response.usage.prompt_tokens,
        {**labels, "gen_ai.token.type": "input"})
    token_histogram.record(response.usage.completion_tokens,
        {**labels, "gen_ai.token.type": "output"})
    duration_histogram.record(
        time.time() - ctx["start"], labels
    )
Trên Aspire Dashboard (tab Metrics) hoặc Grafana, bạn sẽ thấy:
- Token usage theo thời gian → phát hiện prompt nào đang "ăn" nhiều token bất thường, ảnh hưởng chi phí
- P50/P95/P99 latency của LLM call → phát hiện degradation sớm trước khi user phàn nàn
- Tỷ lệ
finish_reason=length→ phát hiện khi nào nên tăngmax_tokens
Quy tắc đơn giản: 1 request bị lỗi → mở Trace. Xu hướng toàn hệ thống → mở Metrics.
Dùng auto-instrumentation ở dự án thật
Mình viết tay span trong demo để bạn hiểu cơ chế bên trong. Ở dự án thật, có thư viện làm hết việc này tự động:
openinference (Arize Phoenix)
pip install openinference-instrumentation-openai
from openinference.instrumentation.openai import OpenAIInstrumentor
OpenAIInstrumentor().instrument()  # patch OpenAI SDK, tự tạo span cho mọi call
Mọi client.chat.completions.create() từ đây sẽ tự có span đầy đủ với các gen_ai.* attribute — không cần with traced_chat_call(...) nữa.
OpenLLMetry (Traceloop)
pip install traceloop-sdk
from traceloop.sdk import Traceloop
Traceloop.init(app_name="travel-agent")  # 1 dòng duy nhất
Hỗ trợ OpenAI, Anthropic, Cohere, LangChain, LlamaIndex out of the box.
Khi nào nên viết tay, khi nào dùng auto?
| Tình huống | Nên làm |
|---|---|
| Học OTel, hiểu cơ chế | Viết tay như demo này |
| Dự án mới, cần nhanh | Dùng auto-instrumentation |
| Cần custom attribute đặc thù của business | Auto + gắn thêm attribute thủ công |
| Dùng framework tự build, không qua OpenAI SDK | Viết tay |
4 sai lầm phổ biến mình hay thấy anh em dính
❌ Sai lầm 1: không tách span tool ra khỏi span Agent
Nhiều người wrap traced_agent() rồi thôi, không tạo traced_tool_call() riêng cho mỗi tool. Kết quả trace trông như thế này:
invoke_agent travel-agent   ████████████████████████  8.2s
└── chat gpt-4o-mini        ████████████████████████  7.8s  ← thấy chat "chậm"?
Nhìn vào trace thấy chat tốn 7.8s — nghĩ ngay model chậm. Thực ra 6.1s nằm trong tool call bên trong không được đo riêng nên bị gộp vào thời gian của Agent. Mỗi tool call phải là 1 span riêng — nguyên tắc bất di bất dịch.
❌ Sai lầm 2: bật CAPTURE_CONTENT=true ở production không nghĩ đến privacy
Attribute gen_ai.input.messages, gen_ai.output.messages, và gen_ai.tool.call.result rất hữu ích khi debug nhưng có thể chứa:
- Thông tin cá nhân của user (tên, địa chỉ, lịch sử hội thoại)
- Dữ liệu nhạy cảm từ tool (kết quả query DB, nội dung tài liệu nội bộ)
- Token hoặc credential nếu prompt không được sanitize kỹ
OTel spec thiết kế mặc định không ghi content là vì lý do này. Ở production, nếu muốn bật, cần có cơ chế redact PII trước khi ghi:
import re

def redact_pii(text: str) -> str:
    text = re.sub(r'\b[\w.]+@[\w.]+\.\w+\b', '[EMAIL]', text)         # email
    text = re.sub(r'\b(0[3-9]\d{8}|\+84\d{9})\b', '[PHONE]', text)   # SĐT VN
    text = re.sub(r'\b\d{9,12}\b', '[ID_NUMBER]', text)               # CMND/CCCD
    return text

if CAPTURE_CONTENT:
    span.set_attribute("gen_ai.input.messages",
        redact_pii(json.dumps(messages)))
❌ Sai lầm 3: quên gắn finish_reasons vào span
gen_ai.response.finish_reasons là attribute "chẩn đoán nhanh" quan trọng nhất nhưng hay bị bỏ quên vì cần đọc từ response object sau khi gọi API.
# Hay bị bỏ sót:
span.set_attribute("gen_ai.response.finish_reasons",
    [c.finish_reason for c in response.choices])
Nếu thiếu attribute này, bạn sẽ không phát hiện được khi nào length bắt đầu xuất hiện nhiều trong production — dấu hiệu context window đang ngày càng bị đẩy đến giới hạn, cần xem xét lại chiến lược chunking prompt.
❌ Sai lầm 4: dùng SimpleSpanProcessor ở production
# ❌ Đừng làm vậy ở production
from opentelemetry.sdk.trace.export import SimpleSpanProcessor
provider.add_span_processor(SimpleSpanProcessor(exporter))

# ✅ Luôn dùng BatchSpanProcessor
from opentelemetry.sdk.trace.export import BatchSpanProcessor
provider.add_span_processor(BatchSpanProcessor(exporter))
SimpleSpanProcessor gửi từng span ngay khi span đóng — mỗi request phải chờ network round-trip đến OTLP endpoint. Với Agent có 4-5 span/request, điều này cộng thêm hàng trăm ms latency không cần thiết. BatchSpanProcessor buffer trong memory và gửi async, overhead < 1ms/span.
Tóm tắt
-
AI Agent là chuỗi nhiều tầng — LLM, Tool, Orchestration. Lỗi có thể nằm ở bất kỳ đâu, debug bằng
print()không scale. -
OpenTelemetry GenAI Semantic Conventions chuẩn hóa cách ghi lại chuỗi đó thành 1 cây trace với tên span/attribute thống nhất (
gen_ai.*) — vendor-neutral, dùng được với mọi backend. -
3 loại span cốt lõi, tách riêng hoàn toàn:
invoke_agent(span cha),chat(mỗi lần gọi LLM),execute_tool(mỗi lần chạy tool). -
Nhìn timeline để biết tầng nào chậm. Nhìn
finish_reasonsđể phát hiện câu trả lời bị cắt cụt. Nhìntool.call.resultđể phân biệt "AI ảo giác" vs "dữ liệu tool sai". -
Content mặc định không ghi — phải opt-in, cân nhắc redact PII trước khi bật ở production.
-
BatchSpanProcessorluôn luôn — overhead < 1ms/span, không làm chậm app. -
Dùng auto-instrumentation (openinference, OpenLLMetry) ở dự án thật để tiết kiệm thời gian, chỉ viết tay khi cần custom logic đặc thù.
Tài liệu tham khảo
Nếu bạn muốn đào sâu hơn, đây là những nguồn mình dùng khi viết bài này — sắp xếp theo thứ tự từ dễ đến khó.
Đọc trước — nền tảng
| Nguồn | Mô tả |
|---|---|
| OpenTelemetry — Getting Started (Python) | Hướng dẫn chính thức, bắt đầu từ zero, có code chạy được ngay |
| Inside the LLM Call: GenAI Observability with OpenTelemetry | Bài blog gốc trên opentelemetry.io, nguồn cảm hứng của bài viết này |
| What is Distributed Tracing? | Giải thích Trace, Span, Attribute theo chuẩn OTel, súc tích và dễ hiểu |
| Aspire Dashboard — Standalone Mode | Cách chạy Aspire Dashboard độc lập (không cần .NET), nhận OTLP trực tiếp |
Đào sâu — GenAI Semantic Conventions
| Nguồn | Mô tả |
|---|---|
| semantic-conventions-genai (GitHub) | Repo chính thức của GenAI Semantic Conventions — nơi spec được update liên tục |
| gen-ai-spans.md | Spec chi tiết cho span chat, invoke_agent, execute_tool — bao gồm tất cả attribute bắt buộc và opt-in |
| gen-ai-metrics.md | Spec cho gen_ai.client.token.usage, gen_ai.client.operation.duration |
| OTel Semantic Conventions Release Notes | Theo dõi khi có attribute mới được thêm vào — GenAI conventions đang evolve nhanh |
Auto-instrumentation — dùng ở dự án thật
| Nguồn | Mô tả |
|---|---|
| openinference — OpenAI Instrumentation | Patch thẳng vào OpenAI SDK, zero code change, follow GenAI semconv |
| OpenLLMetry by Traceloop | Hỗ trợ OpenAI, Anthropic, LangChain, LlamaIndex — 1 dòng setup |
| opentelemetry-instrumentation-fastapi | Auto-instrument FastAPI HTTP layer (span cho mọi route, request/response attributes) |
Production stack — khi cần scale
| Nguồn | Mô tả |
|---|---|
| Grafana + Tempo — Distributed Tracing | Self-hosted trace backend phổ biến nhất, tích hợp tốt với Prometheus/Loki |
| Datadog — OpenTelemetry | Datadog native OTel support, có GenAI dashboard sẵn từ v1.37+ |
| OpenTelemetry Collector | Khi cần pipeline phức tạp: fan-out trace tới nhiều backend, filter/transform trước khi gửi |
| OTel Collector — Contrib Processors | Các processor hay dùng: redaction (che PII), sampling, batch |
MCP & Multi-agent (hướng nâng cao)
| Nguồn | Mô tả |
|---|---|
| Model Context Protocol (MCP) | Spec của Anthropic cho tool server — cần hiểu khi muốn nối trace Agent ↔ MCP server |
| W3C Trace Context | Chuẩn propagate trace context qua HTTP headers — dùng khi Agent và tool server ở 2 process khác nhau |
| OTel — Baggage | Cách propagate metadata tùy chỉnh (như conversation_id) xuyên suốt toàn bộ distributed trace |
Video & talk
| Nguồn | Mô tả |
|---|---|
| Observability for LLM Applications — KubeCon 2024 | Talk từ team OTel về GenAI semconv, cách thiết kế và lý do các quyết định |
| Tracing AI Agents with OpenTelemetry — Arize AI | Demo thực tế dùng openinference + Phoenix UI |