Năm nguyên tắc rút ra từ một ticket bốn dòng — mỗi nguyên tắc neo vào một con số đo được.
Mười lăm phút vào một cuộc họp thiết kế, sơ đồ trên bảng đã có sáu thành phần: một load balancer, một API gateway, một hàng đợi, một tầng cache và hai database nối mũi tên với nhau.
Không ai trong phòng biết hệ thống này phải chịu bao nhiêu request mỗi giây.
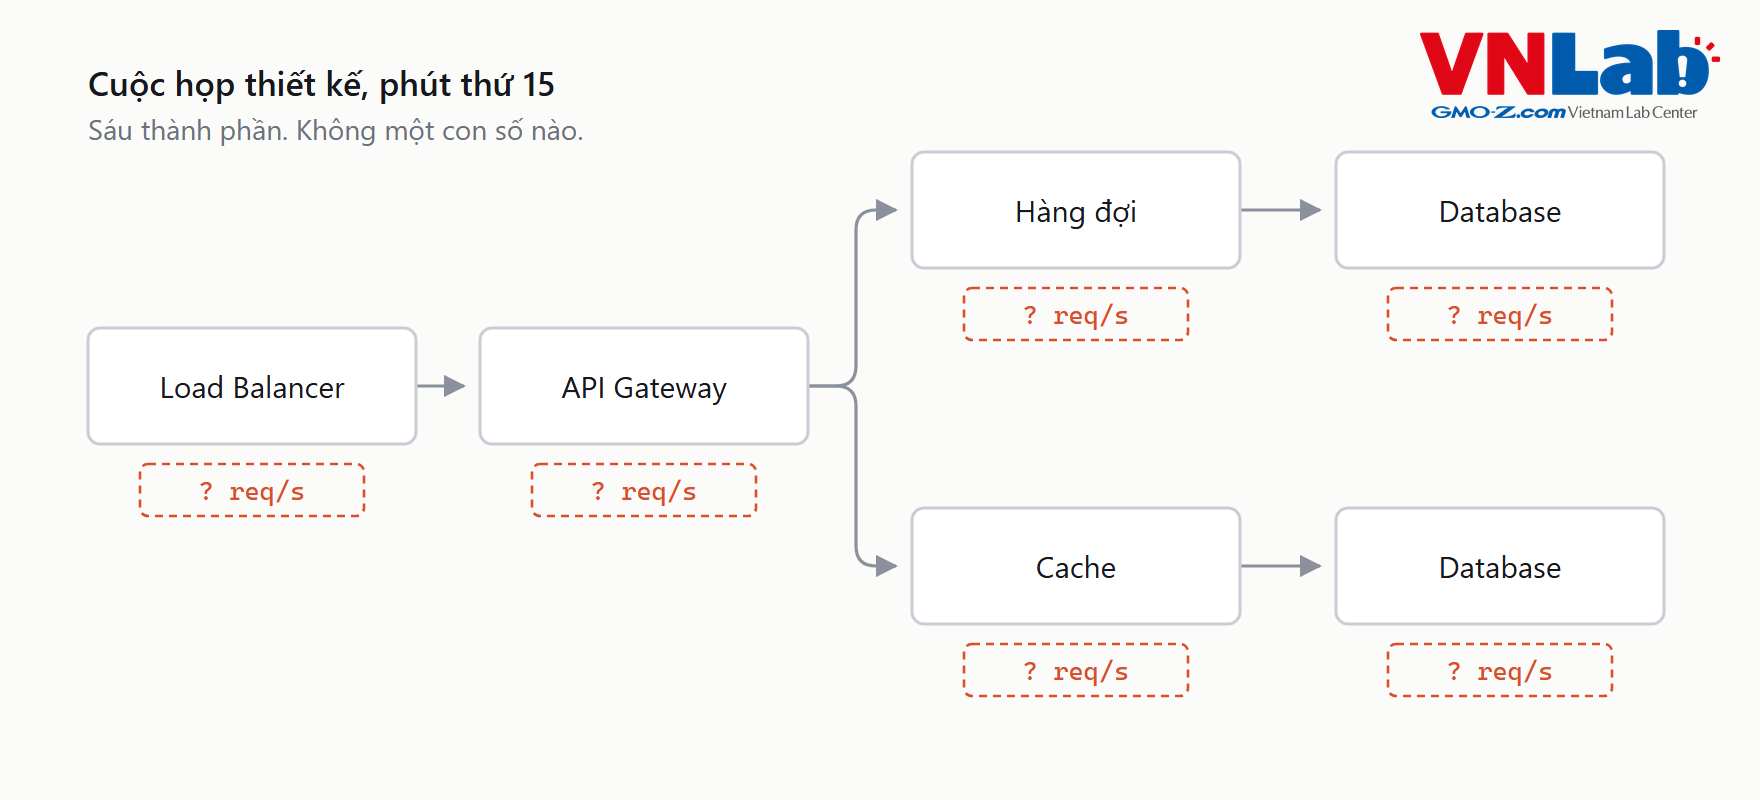
Con số đó quyết định gần như mọi thứ còn lại trên bảng. Luật tôi dùng rất đơn giản: mỗi thành phần trên sơ đồ phải chỉ được vào một con số biện minh cho nó. Chỉ không ra thì xoá.
Bài này đi qua năm câu hỏi để làm được điều đó, chạy trên một bài toán: dịch vụ chia sẻ text kiểu Pastebin. Bài toán đủ nhỏ để nhìn hết từng bước, còn năm câu hỏi thì không phụ thuộc vào nó.
Cái ticket:
[PROJ-142] Dịch vụ chia sẻ đoạn text nội bộ
Cho phép dán một đoạn text (log, stacktrace, config) và nhận về link chia sẻ.
Link có thể đặt hạn tự huỷ.
Không cần đăng nhập.
Cần thống kê lượt xem theo tháng.
Bốn dòng. Nhìn qua là việc của một buổi chiều:
INSERT INTO pastes (shortlink, content) VALUES ('foobar', 'Traceback...');
SELECT content FROM pastes WHERE shortlink = 'foobar';
Hai dòng đó đúng hay sai phụ thuộc hoàn toàn vào quy mô, mà ticket thì không nói quy mô. Đó là chỗ câu hỏi thứ nhất bắt đầu.
1. Con số đâu?
Ticket không nói ba thứ, và ba thứ đó quyết định toàn bộ thiết kế:
| Câu hỏi | Đáp |
|---|---|
| Bao nhiêu người dùng? | 10 triệu |
| Bao nhiêu lượt ghi và đọc mỗi tháng? | 10 triệu ghi, 100 triệu đọc |
| Giữ dữ liệu bao lâu? | Không giới hạn — tính tồn kho ba năm |
Đi hỏi cho ra ba con số này là công việc của bước thiết kế, không phải chọn database hay vẽ sơ đồ. Không có chúng thì ta sẽ thêm cache vì hệ thống nào cũng có cache, và shard vì tuần trước vừa đọc một bài về sharding.
Phần quy đổi thì nhanh. Con số duy nhất cần thuộc lòng:
Một tháng ≈ 2,5 triệu giâyMọi thống kê theo tháng đều quy về thông lượng giây bằng một phép chia:
10 triệu ghi/tháng   ÷ 2,5 triệu giây  =   4 ghi mỗi giây
100 triệu đọc/tháng  ÷ 2,5 triệu giây  =  40 đọc mỗi giây
Rồi tồn kho. Mỗi bản ghi khoảng 1 KB nội dung, cộng metadata chừng 270 byte:
1,27 KB × 10 triệu/tháng  =  12,7 GB mỗi tháng
12,7 GB × 36 tháng        =  ~450 GB sau 3 năm
                             ~360 triệu định danh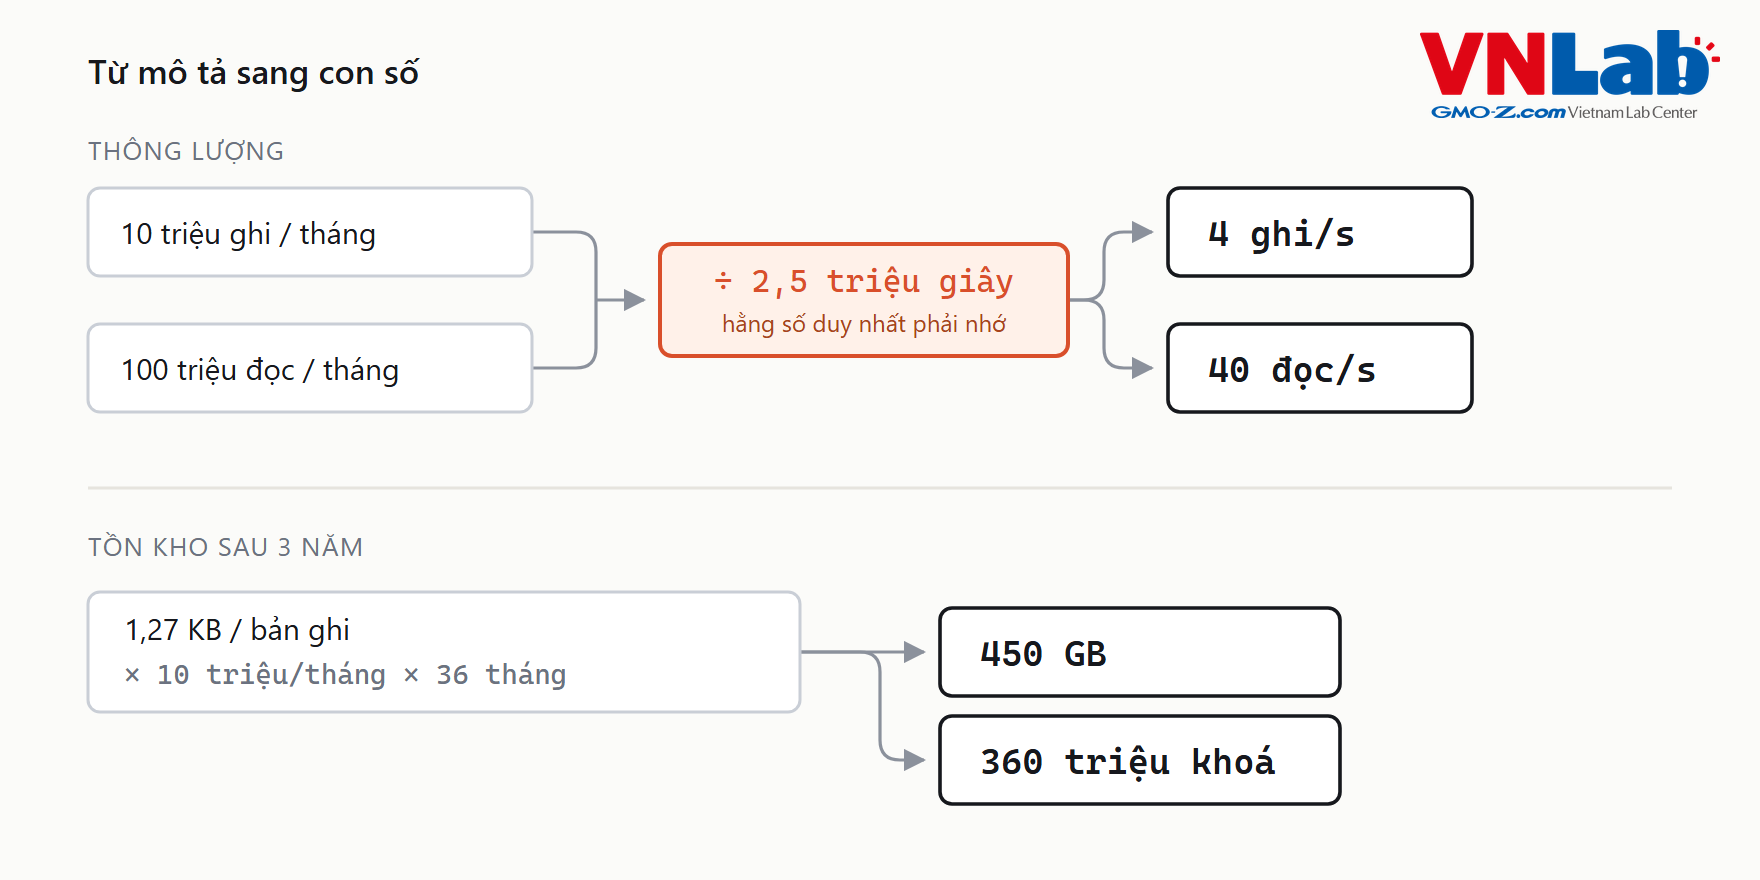
4 · 40 · 450 GB · 360 triệu
Bốn con số, vài phép tính số học, mất chưa tới ba phút. Từ đây trở đi mọi quyết định đều neo vào chúng.
Để ý ngay lúc này: 4 ghi và 40 đọc mỗi giây là tải rất nhẹ — câu hỏi thứ năm sẽ quay lại đúng chỗ này.
Nguyên tắc 1 — Biến mô tả thành con số trước khi vẽ sơ đồ.
2. Chỗ nào ta đang cắt bớt dữ liệu?
Trong bốn dòng yêu cầu, chỗ khó không phải việc lưu text — database làm việc đó mấy chục năm rồi. Chỗ khó là:
Sinh ra một định danh ngắn, không trùng, không đoán được, ở tốc độ bốn cái mỗi giây, suốt ba năm, trên nhiều server chạy song song.
ID tự tăng hỏng theo ba cách. Link xấu dần — hôm nay /7, ba năm sau /359847201. Ai giữ bộ đếm cũng là một câu hỏi khó chịu: mười instance phải hỏi chung một chỗ, chỗ đó vừa là nút cổ chai vừa là single point of failure, tồn tại chỉ để cộng thêm một.
Nhưng cái nghiêm trọng nhất là cách thứ hai. Bản ghi của tôi là 8471923. Vậy bản ghi của người ngay trước tôi là 8471922. Ngồi đếm ngược là duyệt sạch cơ sở dữ liệu.
Và nhớ đây là dịch vụ để làm gì: người ta dán log production vào đây. Trong log production có connection string, có token, có đường dẫn nội bộ, có khi có cả dữ liệu khách hàng lẫn trong stacktrace. Vậy nên đây không còn là vấn đề thẩm mỹ URL — nó là một lỗ hổng liệt kê dữ liệu, và toàn bộ kho paste đọc được bằng một vòng lặp giảm dần.
Lời giải gói trong một dòng:
url = base_encode(md5(ip_address + timestamp))[:7]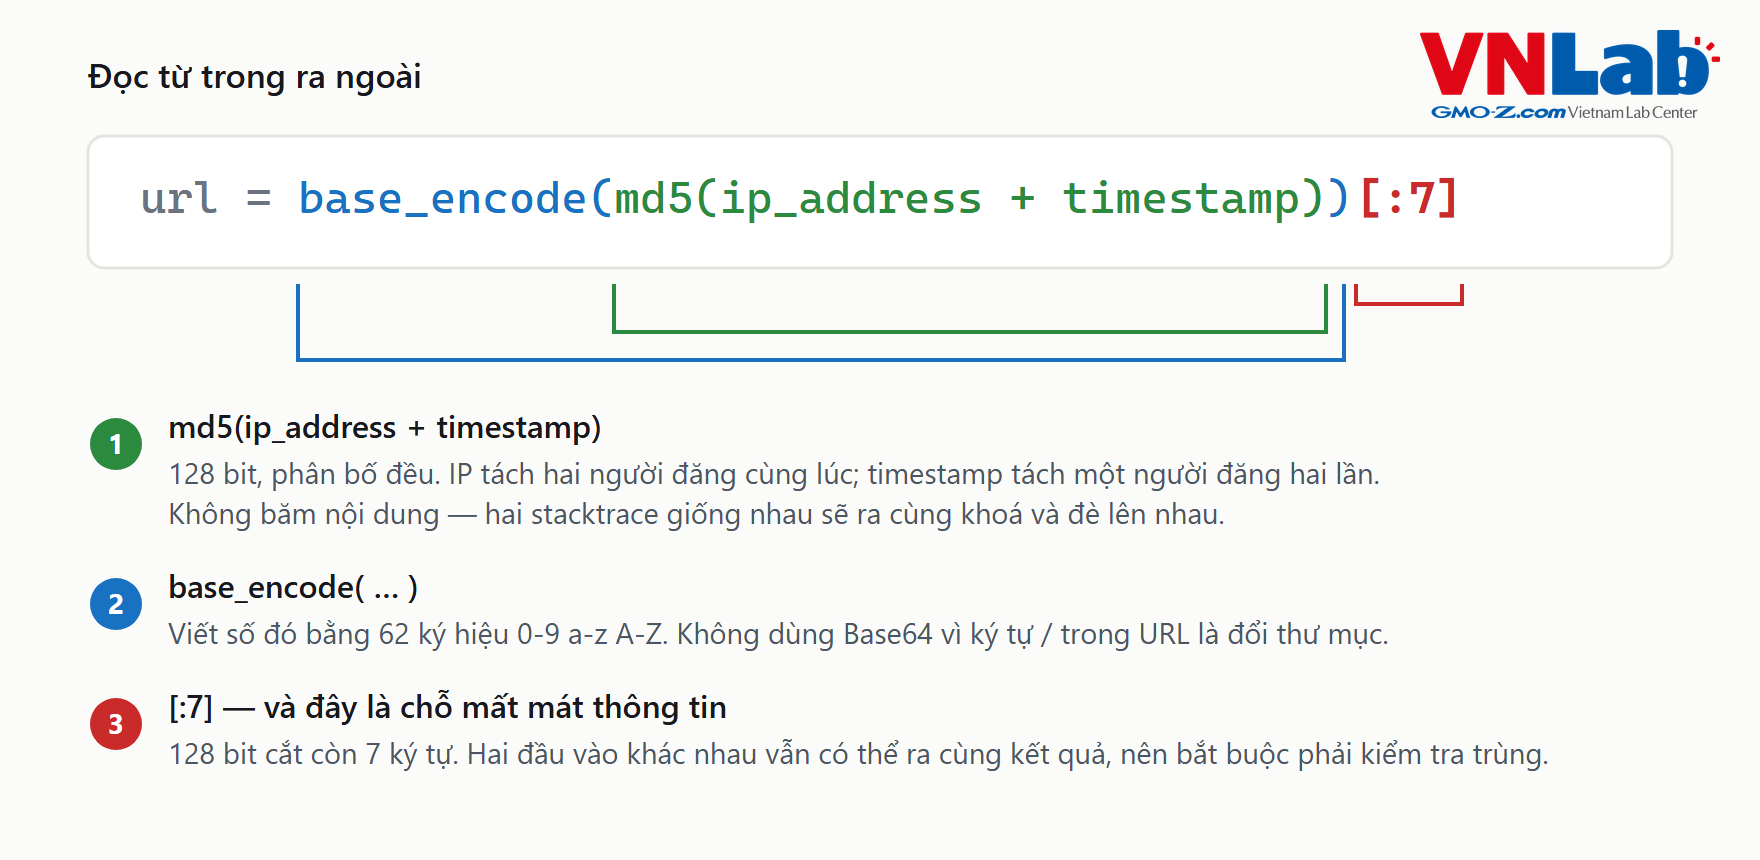
Đọc từ trong ra ngoài. md5(ip_address + timestamp) băm IP ghép thời điểm hiện tại, ra một số 128 bit. Ghép cả hai không phải cho có: hai người đăng cùng lúc thì IP khác nhau, một người đăng hai lần thì timestamp khác nhau. Và tuyệt đối đừng băm nội dung — hai người dán cùng một đoạn stacktrace sẽ ra cùng định danh và đè lên nhau. base_encode viết số đó bằng 62 ký hiệu 0-9 a-z A-Z; không dùng Base 64 vì / trong URL nghĩa là đổi thư mục, một định danh có gạch chéo ở giữa bị hiểu thành đường dẫn hoàn toàn khác.
Còn [:7] — cắt lấy bảy ký tự đầu.
Con số bảy không phải chọn theo cảm giác. Nó là kết quả một phép chia, và phép chia đó lấy đầu vào từ câu hỏi thứ nhất:
62⁷ ≈ 3.500.000.000.000        (3.500 tỷ chuỗi)
360.000.000 / 3.500.000.000.000 ≈ 0,01%
Dùng hết một phần vạn không gian khoá, còn trống 99,99%. Sáu ký tự cũng thừa về mặt số lượng, nhưng không gian chật hơn 62 lần, đổi lại tiết kiệm đúng một ký tự URL. Bảy là chỗ đánh đổi rẻ nhất.
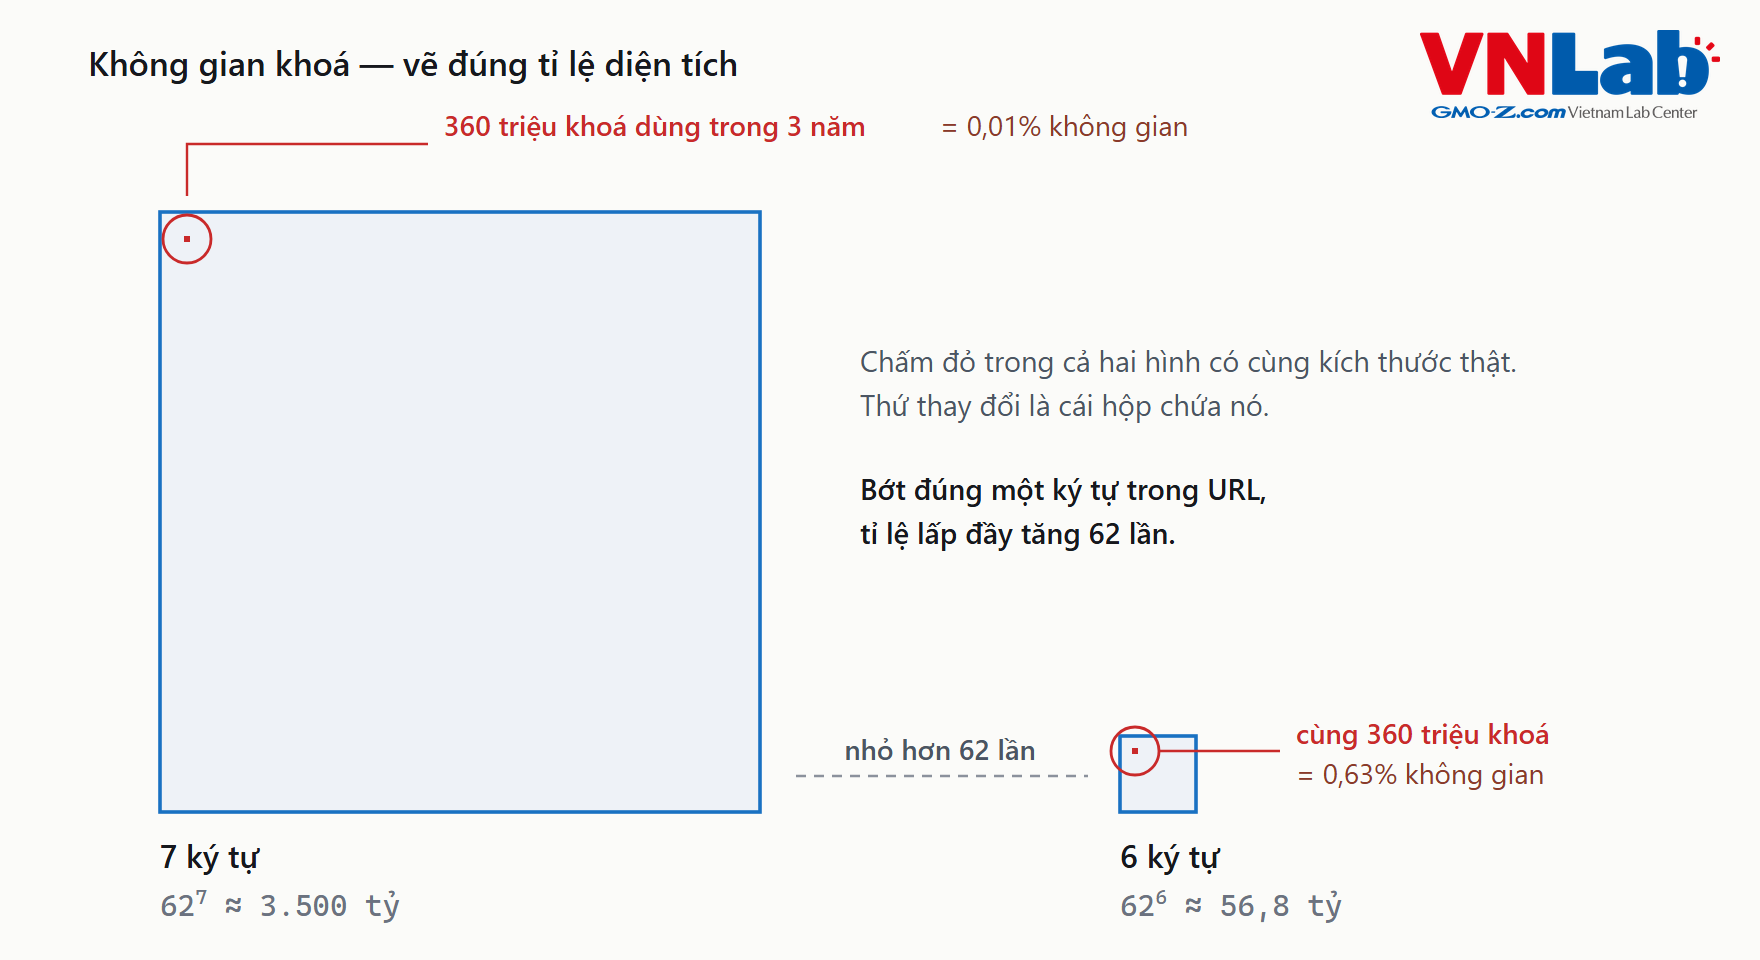
Cái đáng mang về không phải con số bảy. Là chuyện độ dài khoá có thể tính ra được. Người chọn bảy vì đã chia sẽ biết khi nào cần đổi; người chọn bảy vì thấy dịch vụ khác dùng bảy thì sẽ không biết.
Cái bẫy ở [:7]
MD5 cho ra 128 bit. Ta giữ lại bảy ký tự. Tức là vứt đi phần lớn thông tin — và đã vứt bớt thì hai đầu vào hoàn toàn khác nhau, sau khi cắt, vẫn có thể ra giống hệt nhau.
Nên luồng ghi không được phép là "sinh chuỗi rồi lưu":
sinh chuỗi → hỏi database: chuỗi này có rồi chưa?
                  ├─ có rồi  → sinh lại
                  └─ chưa có → dùng
Rất dễ tặc lưỡi bỏ bước kiểm tra, vì xác suất đụng nhau thấp thật. Nhưng "rất thấp" không phải "không". Ở 10 triệu bản ghi mỗi tháng, một thứ có xác suất một phần triệu vẫn xảy ra cả chục lần mỗi tháng. Nhân 36 tháng thì ta đang nói tới hàng trăm lần.
Mỗi lần là một lần dữ liệu người này đè lên dữ liệu người khác — không exception, không log, không gì bất thường trên monitoring. Chỉ có một cái ticket ba tháng sau: link của tôi giờ ra nội dung của người khác, và lúc đó thì không truy lại được nữa.
Chỗ đặt bước kiểm tra là dòng cuối của schema:
shortlink char(7) NOT NULL
expiration_length_in_minutes int NOT NULL
created_at datetime NOT NULL
paste_path varchar(255) NOT NULL
PRIMARY KEY(shortlink)
Đặt shortlink làm primary key thì database làm luôn hai việc: tạo index để tra cứu nhanh, và chặn trùng ngay ở tầng lưu trữ — kể cả khi code ứng dụng có bug. Ràng buộc quan trọng thì đặt ở tầng thấp nhất có thể — code ứng dụng bị viết lại, bị bỏ sót, bị một script chạy tay bypass; ràng buộc ở database thì không.
(Chi tiết nhỏ: char(7) chứ không phải varchar(7). Độ dài cố định thì mỗi dòng cố định, index gọn hơn. Nhỏ, nhưng là loại chi tiết ba năm sau không còn cơ hội sửa.)
Câu hỏi này dùng được ở mọi chỗ bạn rút gọn hay dẫn xuất ra một giá trị rồi coi nó như duy nhất: khoá rút gọn URL, khoá chống trùng đơn hàng, idempotency key, cache key ghép từ vài trường. Chỗ nào cắt, chỗ đó cần một cái khoá duy nhất ở tầng lưu trữ.
Nguyên tắc 2 — Chỗ nào cắt bớt dữ liệu, chỗ đó cần một bước kiểm tra. Đặt nó ở tầng thấp nhất có thể.
3. Cột này có bao giờ nằm trong WHERE không?
Đây là quyết định quan trọng nhất của cả thiết kế, và nó không nằm ở phần sinh khoá vừa nói ở trên.
Bảng mà chín trên mười người sẽ viết:
| shortlink | content |
|---|---|
foobar | "Traceback... (1 KB)" |
x7yz9qa | "def main(): ... (1 KB)" |
Nó chạy tốt trong sáu tháng đầu, và đó là lý do vấn đề khó phát hiện sớm.
1 KB mỗi dòng × 360 triệu dòng = 450 GBỞ kích thước đó, index không còn nằm vừa trong RAM. Mọi truy vấn bắt đầu phải xuống ổ đĩa — chậm hơn khoảng tám mươi lần.
Đáng để ý là cách nó hỏng. Hệ thống không sập — nó chậm dần đều, mỗi tháng tệ hơn tháng trước một chút, nên không có thời điểm nào rõ ràng để kích hoạt việc xử lý. Đến khi có người phàn nàn thì ta đang phải migrate 450 GB dữ liệu đang chạy production.
Đây là loại nợ kỹ thuật đắt nhất: loại không có ngày đáo hạn rõ ràng. Và cách tránh nó nằm trong một câu hỏi:
Cột này có bao giờ nằm trong mệnh đề
WHEREkhông?
Với content, câu trả lời là không. Không ai chạy WHERE content LIKE. Nội dung chỉ được lấy ra ở bước cuối cùng, sau khi đã tìm thấy dòng bằng định danh.
Vậy thì đừng để nó ngồi trong database.
┌─── Database (~271 byte/dòng) ────────┐
│ shortlink │ paste_path       │ ...   │
│ foobar    │ s3://bucket/ab12 │       │
└──────────────────────────────────────┘
                  │
                  ▼
┌────── Object Store (S3) ─────────────┐
│ ab12 → "Traceback... (1 KB)"         │
└──────────────────────────────────────┘
450 GB xuống còn khoảng 97. Nhưng con số đáng giá hơn là kích thước index: cột định danh chỉ 7 byte mỗi dòng. Toàn bộ index nằm gọn trong RAM, và nằm đó mãi — kể cả khi dữ liệu tăng gấp mười.
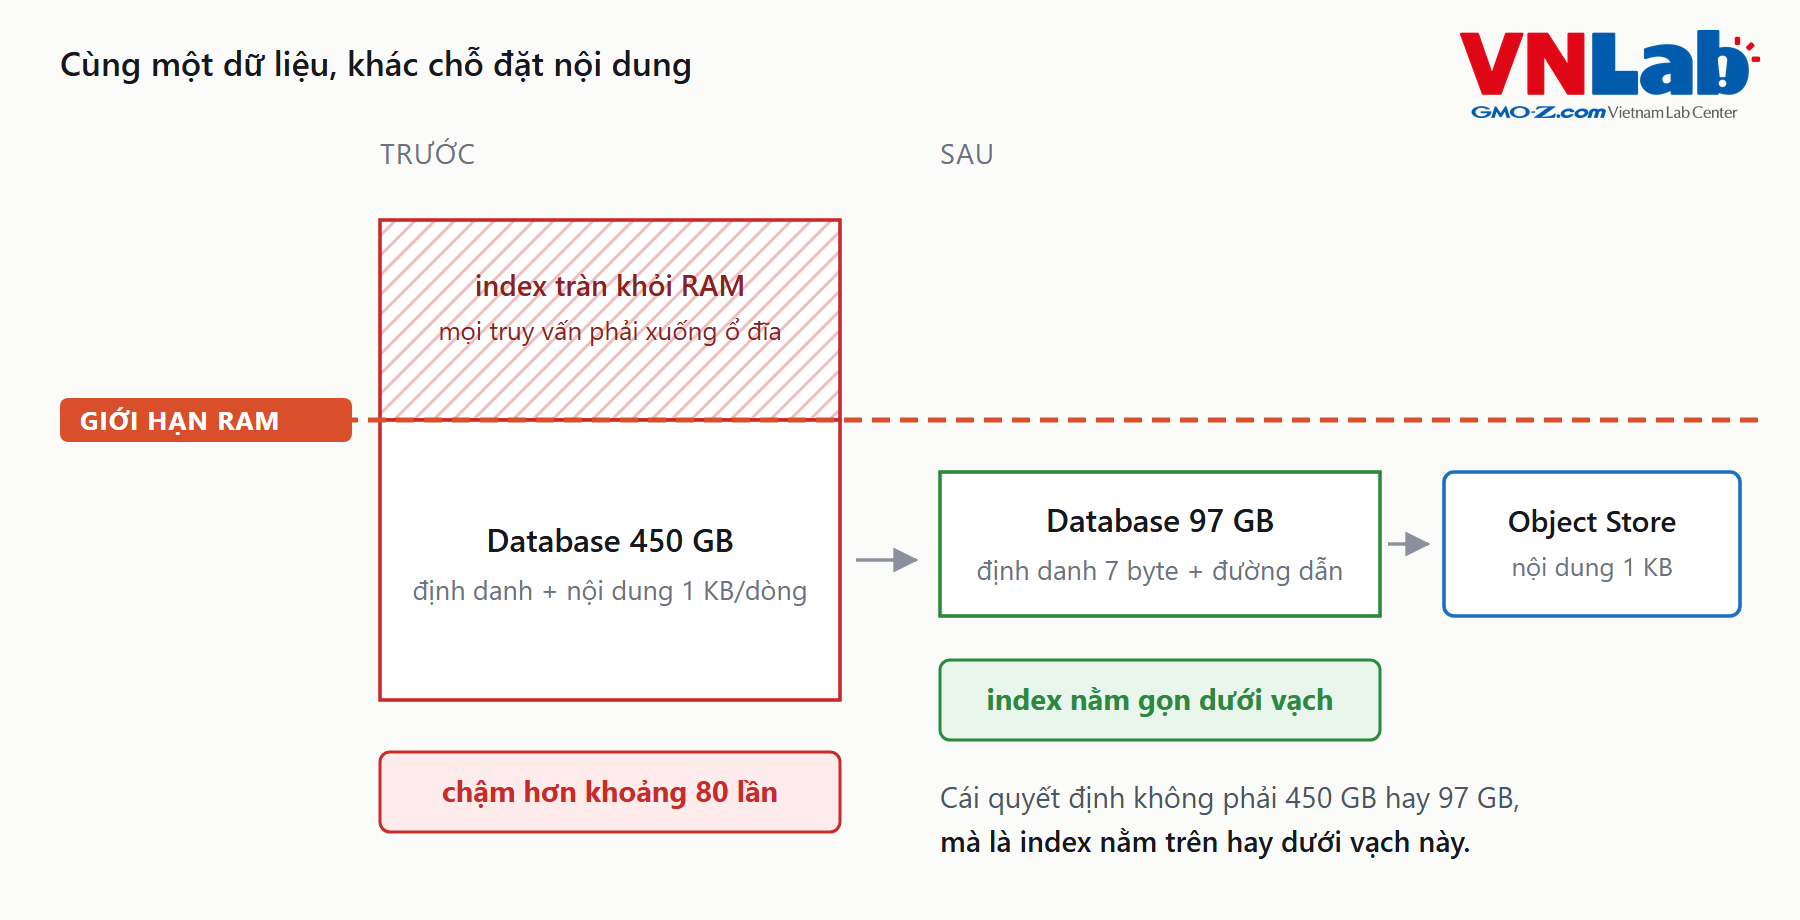
Mô hình này giống quầy giữ đồ: cuốn sổ của nhân viên ghi thẻ 47 → giá B, ngăn 3, còn cái áo khoác nằm trong kho phía sau. Cuốn sổ tra cứu nhanh chính vì nó không chứa áo khoác.
Đây là nguyên tắc dùng được ngay tuần này, ở cái schema bạn đang viết. Ảnh đại diện. File đính kèm. Bản PDF xuất ra. Payload JSON của webhook. Response log của API bên thứ ba. Nội dung email đã gửi. Mỗi lần định thêm một cột TEXT hay BLOB, hỏi đúng một câu — thứ này có bao giờ nằm trong WHERE không?
Nếu không, nó không thuộc về database.
Nguyên tắc 3 — Database giữ chỉ mục. Kho riêng giữ nội dung.
4. Yêu cầu này cần nhanh tới mức nào?
Còn một dòng trong ticket chưa động tới: cần thống kê lượt xem theo tháng.
Cách hiển nhiên là một dòng:
UPDATE pastes SET views = views + 1 WHERE shortlink = 'foobar';Và một dòng đó vừa biến hệ thống thành một thứ khác hẳn:
Trước:  40 đọc/giây,  4 ghi/giây
Sau:    40 đọc/giây, 44 ghi/giây
Ta vừa gắn một lượt ghi vào mỗi lượt đọc — ở một hệ thống mà đọc nhiều gấp mười lần ghi. Hai hệ quả: read replica trở nên vô dụng cho đường đi này vì đây là lệnh ghi; và một bản ghi được chia sẻ rộng sẽ có hàng nghìn request cùng tranh khoá trên đúng một dòng.
Rồi quay lại đọc yêu cầu. Nó viết là: thống kê theo tháng.
Không ai cần con số này realtime. Mà web server thì đã ghi log mọi request rồi — dữ liệu có sẵn, chỉ là chưa đếm.
def mapper(self, _, line):
    yield (self.extract_year_month(line), self.extract_url(line)), 1

def reducer(self, key, values):
    yield key, sum(values)
mapper biến mỗi dòng log thành một lá phiếu, reducer đếm phiếu, chạy mỗi đêm. Không đụng một chút nào vào đường đi của người dùng.
Bài học không phải "dùng MapReduce". Là thế này: cùng một mô tả tính năng, chỉ đổi ràng buộc độ trễ từ "theo tháng" sang "realtime", và ta đang xây một thứ hoàn toàn khác — có thể cần counter trong Redis, cần gom batch, cần chấp nhận số liệu xấp xỉ.
Ràng buộc độ trễ nằm rải trong ngôn ngữ tự nhiên của ticket và rất dễ đọc lướt qua: theo tháng, gần như tức thì, cuối ngày, khách hàng thấy ngay, báo cáo hàng quý. Mỗi cụm như vậy đều là một quyết định kiến trúc, dù nó chỉ trông như một chi tiết mô tả.
Nguyên tắc 4 — Ràng buộc độ trễ là ràng buộc thiết kế. "Theo tháng" và "realtime" là hai hệ thống khác nhau.
5. Con số nào biện minh cho thành phần này?
Sau bốn câu hỏi về scale, câu cuối nghe như phải có lời đáp phức tạp: với tải này cần bao nhiêu database?
Một.
Một máy PostgreSQL hay MySQL cấu hình bình thường xử lý 4 ghi và 40 đọc mỗi giây mà không cần đổ mồ hôi. Không sharding. Không chia database theo chức năng. Không hàng chục instance.
Thứ thật sự cần chỉ có ba: một cụm master-slave (master nhận ghi, slave nhận đọc và làm bản dự phòng), vài read replica cho phần đọc trượt cache, và một tầng cache.
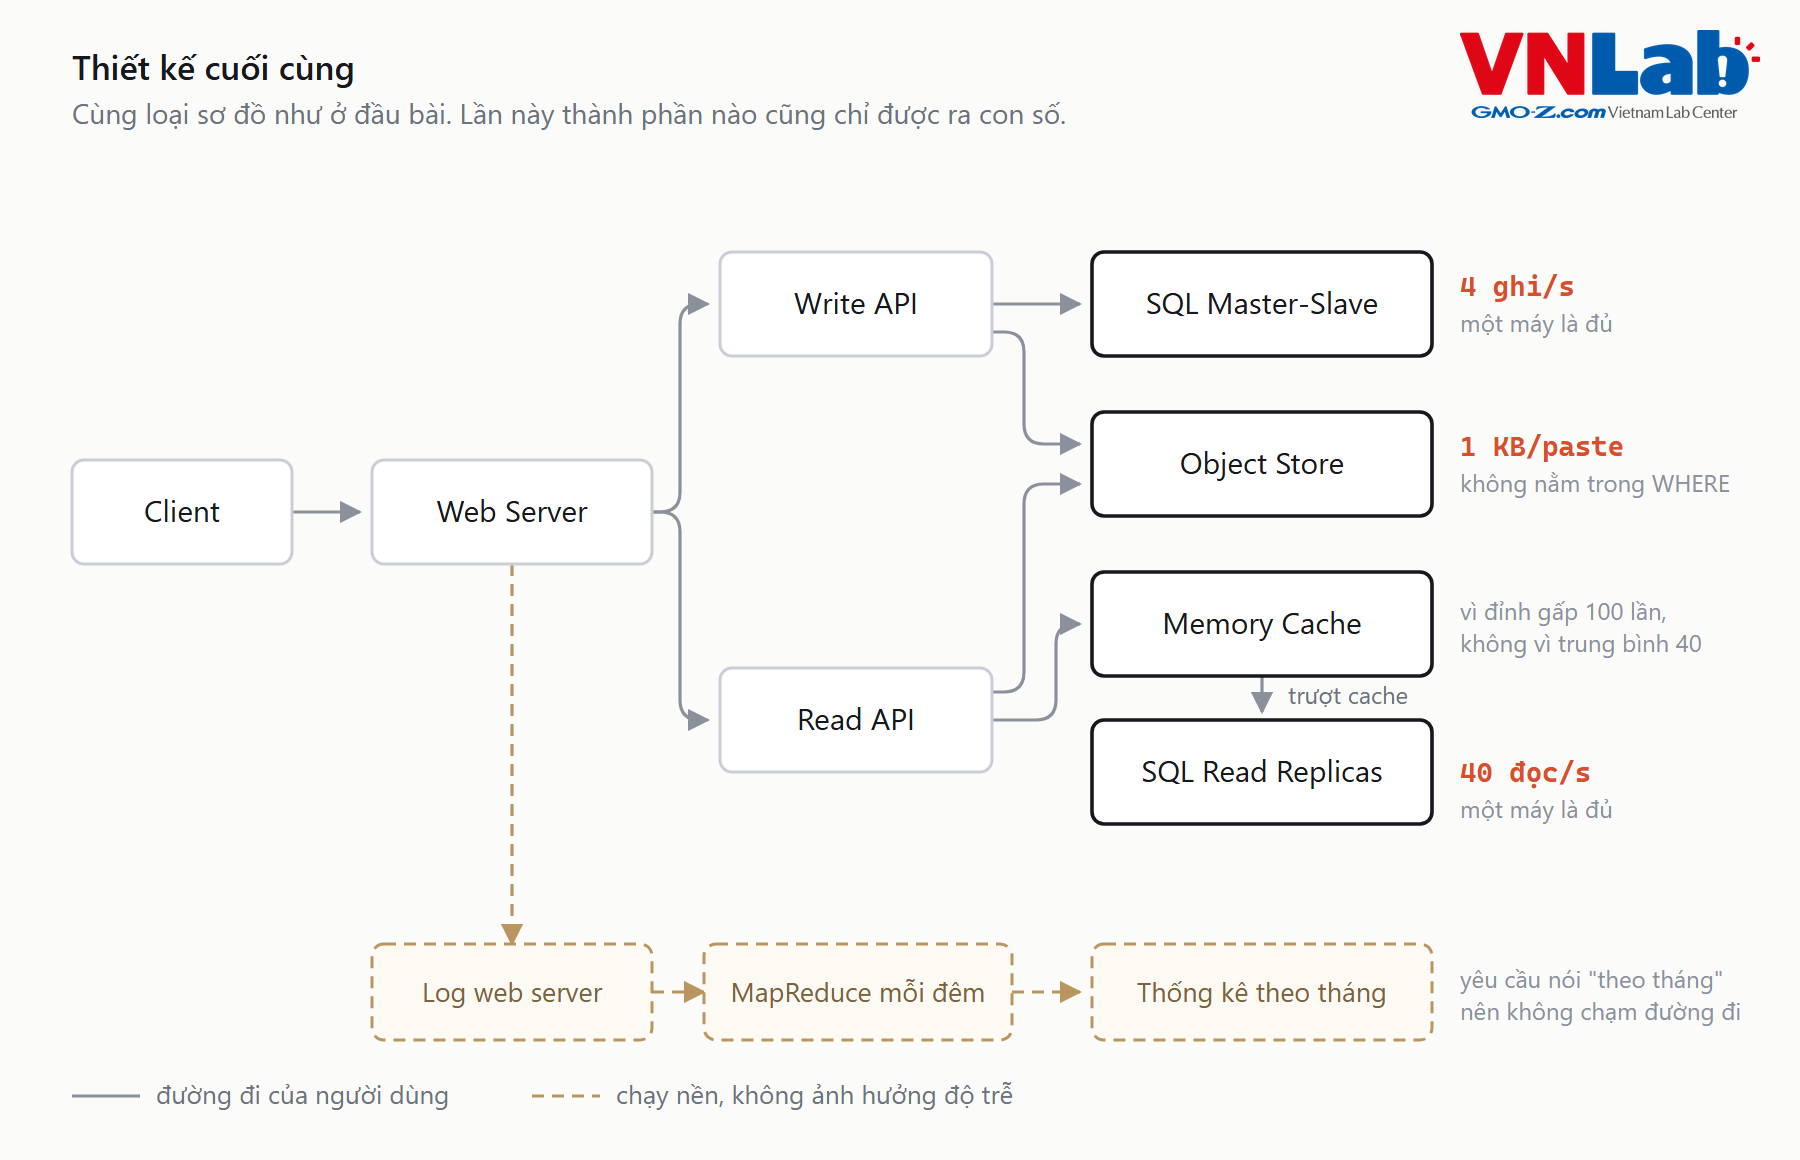
Tầng cache đó biện minh bằng con số nào? Không phải bằng 40 request mỗi giây — database làm được việc đó một mình. Nó biện minh bằng một dòng khác trong yêu cầu, dòng ta hay đọc lướt: traffic không phân bố đều. Trung bình 40 không có nghĩa là lúc nào cũng 40. Khi một bản ghi bất ngờ được chia sẻ khắp công ty, con số tức thời có thể gấp trăm lần. Cache tồn tại vì cái đỉnh đó, không vì cái trung bình.
Đó là toàn bộ thiết kế. Cám dỗ vẽ thêm thì có thật: ta vừa đọc về consistent hashing, ta biết cách shard theo range, và sơ đồ trên bảng trông hơi đơn giản so với công sức bỏ ra. Thêm một tầng nữa thì mất gì?
Mất bốn thứ, và cả bốn đều có hoá đơn:
| Chi phí | |
|---|---|
| Hạ tầng | Sáu node thay vì hai, chạy 24/7, trong ba năm |
| Vận hành | Mỗi thành phần là một thứ phải giám sát, đặt cảnh báo, vá lỗi — và phải có người biết cách khôi phục lúc ba giờ sáng |
| Thay đổi | Dữ liệu đã shard thì truy vấn cross-shard trở nên đắt. Cái tính năng "tìm tất cả bản ghi từ cùng một IP" mà ba tháng nữa sẽ có người yêu cầu — giờ nó là dự án hai tuần thay vì một câu WHERE |
| Người mới | Người vào team sau bạn phải hiểu hết sơ đồ đó trước khi sửa được một dòng |
Sharding không sai. Sharding khi chưa có số liệu nói là cần thì sai — vì ta trả trước toàn bộ bốn hoá đơn kia để mua một thứ chưa dùng đến, và có thể không bao giờ dùng đến.
Câu đúng để kết thúc một buổi thiết kế là câu này:
Với tải hiện tại và dự phóng ba năm, một cụm master-slave cộng một tầng cache là đủ. Tôi đặt cảnh báo ở ngưỡng X, và sẽ tính đến sharding khi số liệu đo được chạm ngưỡng đó.
Vế thứ hai mới là phần quan trọng. Nó không phải "không bao giờ sharding", mà là gắn quyết định đó vào một con số quan sát được thay vì vào linh cảm.
Nguyên tắc 5 — Gắn mỗi thành phần vào con số biện minh cho nó. Không chỉ ra được con số thì thành phần đó chưa nên có mặt.
Bảng kiểm
Năm câu hỏi, không kèm bài toán:
- Con số đâu? Bao nhiêu người dùng, bao nhiêu ghi/đọc mỗi tháng, giữ dữ liệu bao lâu. Chia cho 2,5 triệu giây ra thông lượng giây. Chưa có ba con số này thì chưa vẽ sơ đồ.
- Chỗ nào ta đang cắt bớt dữ liệu? Mọi chỗ rút gọn, băm, hay dẫn xuất ra một giá trị rồi coi nó là duy nhất đều cần một ràng buộc duy nhất ở tầng lưu trữ — không chỉ ở tầng ứng dụng.
- Cột này có bao giờ nằm trong
WHEREkhông? Nếu không, nó không thuộc về database. Áp ngay vào cộtTEXT/BLOBgần nhất bạn định thêm. - Yêu cầu này cần nhanh tới mức nào? Đọc kỹ các cụm chỉ độ trễ trong ticket. Chúng quyết định kiến trúc y như phần mô tả chức năng.
- Con số nào biện minh cho thành phần này? Chỉ không ra thì xoá khỏi sơ đồ, đặt cảnh báo ở ngưỡng, rồi đi làm việc khác.
Bài toán ở đây chỉ là bốn dòng ticket, nhưng năm câu hỏi thì dùng được cho cái ticket đang mở trên máy bạn lúc này.
Bốn câu hay bị hỏi lại
"Sao không dùng UUID cho gọn?"
Được, và nó giải quyết cả va chạm lẫn chuyện đoán trước. Nhưng UUID dài 36 ký tự — một link chia sẻ dài như vậy thì mất luôn mục đích. Đây là đánh đổi giữa độ dài và độ phức tạp, không phải chuyện đúng sai.
"MD5 bị coi là không an toàn mà?"
Đúng, với mục đích mật mã. Ở đây ta không dùng nó để bảo mật mà để phân bố đều. Nếu cần chống đoán ở mức bảo mật thật thì nên lấy từ nguồn ngẫu nhiên mã hoá an toàn, thay vì băm dữ liệu dự đoán được như IP và timestamp.
"Object Store chậm hơn database mà?"
Cho một lần lấy đơn lẻ thì có, thêm vài chục mili giây. Nhưng ta đổi lấy việc index luôn nằm trong RAM — thứ ảnh hưởng tới mọi truy vấn chứ không riêng truy vấn đó. Và tầng cache che phần lớn độ trễ này cho các bản ghi phổ biến.
"Sao không cache thẳng ở CDN?"
Được, và nên, cho nội dung công khai không đặt hạn. Với nội dung có hạn tự huỷ thì phải xử lý invalidation — thêm một tầng phức tạp, và theo nguyên tắc 5 thì tầng đó cần một con số biện minh.