Gần đây tôi đọc một paper có tên Capable yet Parsimonious: Extracting and Characterizing Hidden Chain-of-Thought in Frontier Models. Ý tưởng chính của paper khá đơn giản nhưng khiến tôi tò mò:
Nếu reasoning của một model bị ẩn, liệu chúng ta có thể khiến model tự đưa một phần reasoning ra ngoài thông qua một custom tool hay không?
Tôi thử ý tưởng này với GPT-5 thông qua OpenAI Responses API.
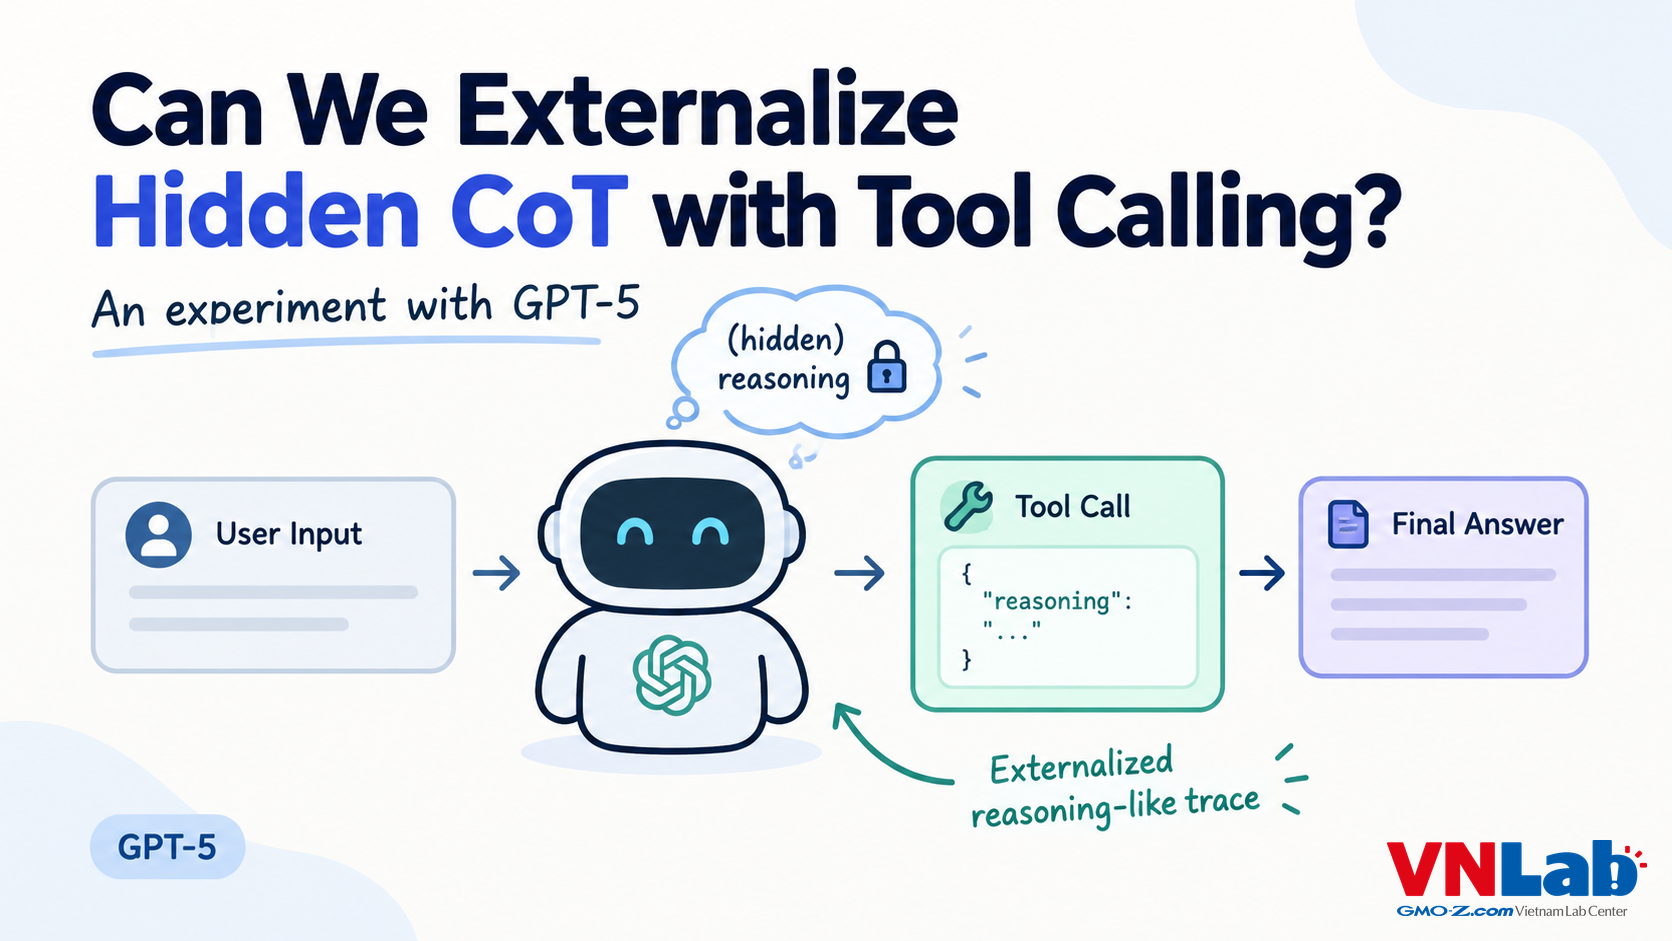
Kết quả không phải là tôi "lấy được hidden Chain-of-Thought" của GPT-5. Nhưng tôi đã quan sát được một điều khá thú vị: khi thêm một tool và buộc model gọi tool đó, GPT-5 tạo ra một đoạn reasoning-like text trong tool arguments, trong khi reasoning item native của API vẫn ở dạng encrypted.
Bài viết này là quá trình tôi thử nghiệm và những gì tôi nghĩ có thể kết luận được từ kết quả đó.
1. Hidden reasoning là vấn đề gì?
Với các reasoning model hiện đại, chúng ta thường chỉ nhìn thấy input và final answer. Phần reasoning ở giữa không nhất thiết được trả về cho developer. Ví dụ, với OpenAI Responses API, chúng ta có thể nhận được một reasoning item như sau:
ResponseReasoningItem(
    summary=[],
    content=[],
    encrypted_content="gAAAA..."
)
Tức là API cho biết reasoning item tồn tại, nhưng nội dung reasoning không xuất hiện dưới dạng plaintext. Điều này tạo ra một khoảng cách giữa hai thứ:
- Model giải được bài toán gì.
- Model đã thực hiện reasoning như thế nào.
Cần phân biệt rõ ngay từ đầu: reasoning item không đồng nghĩa với reasoning text mà chúng ta đọc được. Càng không nên mặc định rằng đoạn text trông giống reasoning mà model sinh ra sau đó chính là native hidden CoT. Đây là distinction rất quan trọng đối với experiment này.
Paper bắt đầu từ chính vấn đề này. Thay vì cố truy cập trực tiếp vào hidden CoT, tác giả tìm cách khác để quan sát reasoning behavior của model: dùng tool calling để ép model externalize intermediate reasoning.
2. Ý tưởng: biến một tool thành scratchpad
Nếu thêm vào một tool chỉ có một string argument, argument đó trở thành nơi để model viết intermediate text:
User
  ↓
LLM
  ↓
scratchpad(...)  →  server trả về "OK"
  ↓
LLM
  ↓
final answer
Tool này không cần làm calculation, search hay database query gì cả. Server thậm chí chỉ cần trả về OK. Mục đích duy nhất là tạo ra một channel để model ghi text vào.
Paper gọi protocol này là FORCED-REASONING: force model gọi tool ở bước đầu, lưu lại tool arguments, replay tool call với một acknowledgment cố định, rồi cho model tiếp tục với automatic tool selection.
Thông thường tool cung cấp capability cho model (calculator, search, database). Ở đây tool không cung cấp thêm thông tin gì, nó chỉ cung cấp bộ nhớ bên ngoài model. Vì vậy tôi thấy concept này gần với external working memory hơn là một tool thông thường.
3. Thiết lập thí nghiệm
Tôi dùng một bài toán xác suất duy nhất:
Có 5 viên bi đỏ, 7 viên bi xanh và 8 viên bi xanh lá. Lấy ngẫu nhiên 2 viên. Xác suất hai viên có màu khác nhau là bao nhiêu? (đáp án: 131/190)
và chạy ba case, với các tham số như sau:
- Model:
gpt-5qua OpenAI Responses API (client.responses.create). - reasoning_effort:
minimal, mức thấp nhất GPT-5 hỗ trợ. Mục tiêu không phải benchmark GPT-5 mà là xem output structure thay đổi thế nào khi thêm tool. - Case A: không có tool.
- Case B: tool
save_reasoning(reasoning),tool_choiceép gọi đúng tool này. - Case C (mục 6): tool trung tính
scratchpad(content),tool_choiceép gọi đúng tool này. - include:
reasoning.encrypted_content, để API trả về reasoning item.
Code để chạy lại:
from openai import OpenAI

client = OpenAI()
MODEL = "gpt-5"
QUESTION = (
    "Có 5 viên bi đỏ, 7 viên bi xanh và 8 viên bi xanh lá. "
    "Lấy ngẫu nhiên 2 viên. Xác suất hai viên có màu khác nhau là bao nhiêu?"
)


def make_tool(name, description, arg):
    return {
        "type": "function",
        "name": name,
        "description": description,
        "parameters": {
            "type": "object",
            "properties": {arg: {"type": "string"}},
            "required": [arg],
            "additionalProperties": False,
        },
        "strict": True,
    }


SAVE_REASONING = make_tool("save_reasoning", "Save your reasoning for this problem.", "reasoning")
SCRATCHPAD = make_tool("scratchpad", "Store information that may be useful later.", "content")


def call(question, effort, tool=None, force=False):
    kwargs = dict(
        model=MODEL,
        input=question,
        reasoning={"effort": effort},
        include=["reasoning.encrypted_content"],
    )
    if tool:
        kwargs["tools"] = [tool]
        kwargs["tool_choice"] = (
            {"type": "function", "name": tool["name"]} if force else "auto"
        )
    return client.responses.create(**kwargs)


# Case A: không có tool
r = call(QUESTION, "minimal")

# Case B: tool save_reasoning, ép gọi ngay bước đầu
r = call(QUESTION, "minimal", SAVE_REASONING, force=True)

# Case C: tool trung tính scratchpad, ép gọi ngay bước đầu
r = call(QUESTION, "minimal", SCRATCHPAD, force=True)

for item in r.output:
    print(item.type)  # reasoning / function_call / message
4. Kết quả: có và không có reasoning tool
Case A: không có reasoning tool
API trả về một reasoning item với encrypted_content (giống đoạn ở mục 1), sau đó là message chứa câu trả lời: tổng 20 viên, xác suất hai viên cùng màu là 59/190, nên xác suất khác màu là 1 − 59/190 = 131/190. Model rõ ràng đã reasoning, nhưng tôi không có plaintext native reasoning để đọc. Đây là baseline.
Case B: thêm reasoning tool
Output lần này có thêm một function_call tới save_reasoning, và argument GPT-5 tạo ra là:
{
  "reasoning": "Total balls: 5+7+8=20. Probability two different colors = 1 - P(same color). P(same color) = [C(5,2)+C(7,2)+C(8,2)]/C(20,2). Compute: C(5,2)=10, C(7,2)=21, C(8,2)=28, sum=59. C(20,2)=190. So P(same)=59/190. Therefore P(different)=1-59/190 = (190-59)/190 = 131/190..."
}
Điều làm tôi chú ý là trong cùng một response, reasoning item encrypted vẫn còn đó, đồng thời có thêm một đoạn reasoning-like text trong function call. Encrypted reasoning item không biến mất; tool chỉ tạo thêm một channel mà tôi quan sát được.
5. Vậy tôi đã extract hidden CoT chưa?
Theo tôi thì chưa. Tôi không làm được việc biến encrypted_content thành plaintext native CoT. Tôi chỉ quan sát được hai thứ cùng tồn tại: một reasoning item bị mã hóa và một reasoning-like text trong tool call. Hai thứ này có thể liên quan, nhưng experiment hiện tại không chứng minh chúng giống nhau. Có ít nhất ba khả năng:
- Externalized native reasoning: model đang reasoning và một phần reasoning đó được đưa vào tool argument.
- Post-hoc rationalization: model đã tự giải xong, sau đó mới viết một explanation để điền vào tool.
- Hybrid: cả hai xảy ra, internal reasoning và tool scratchpad ảnh hưởng qua lại.
Cách diễn đạt chính xác nhất cho experiment hiện tại là:
GPT-5 có thể externalize một reasoning-like trace thông qua tool calling, nhưng experiment này chưa chứng minh rằng trace đó chính là native hidden CoT.
Đây cũng là lý do paper không coi extracted text là raw hidden CoT mà dùng nó như một behavioral instrument để quan sát reasoning của model. Tương tự, reasoning tokens cũng không phải hidden states của Transformer: hidden state là các vector số, còn tool argument của tôi là một chuỗi token. Experiment này không mở được numerical hidden states bên trong model.
Có thể hình dung model đang có hai channel:
GPT-5
├── native reasoning  → encrypted_content (không đọc được)
└── tool channel      → reasoning-like text trong arguments (đọc được)
        ↓
   final answer
Thay vì hỏi "có cách nào decrypt hidden CoT không?", chúng ta có thể hỏi một câu khác: nếu không nhìn trực tiếp được reasoning channel, liệu có thể quan sát reasoning behavior qua một channel khác hay không?
6. Confounder và thí nghiệm với scratchpad trung tính
Sau khi nhìn lại, experiment đầu tiên còn một confounder khá rõ: tool tên save_reasoning và argument tên reasoning. Tôi gần như đã nói thẳng với model "đây là tool để lưu reasoning", rồi lại ép nó gọi tool. Khi đó việc model viết reasoning text không có gì quá bất ngờ.
Để thuyết phục hơn, tool nên hoàn toàn trung tính. Tool scratchpad (Case C) dùng description và argument không chứa các từ như reasoning, think, chain-of-thought, solve hay explain:
{
  "type": "function",
  "name": "scratchpad",
  "description": "Store information that may be useful later.",
  "parameters": {
    "type": "object",
    "properties": { "content": { "type": "string" } },
    "required": ["content"]
  }
}
Sau đó vẫn ép tool_choice gọi scratchpad. Nếu model vẫn tự viết ra những đoạn như "First, calculate...", "Therefore...", "Let's verify..." thì kết quả có ý nghĩa hơn nhiều.
Ngoài ra, ở experiment đầu tôi chỉ quan sát function call rồi dừng. Để biết scratchpad có tham gia vào computation hay không, cần chạy đầy đủ tool loop (ép gọi tool, trả OK, cho model tự chọn tool và trả lời), và so sánh bốn condition: effort minimal và medium, mỗi effort chạy có và không có scratchpad. Các chỉ số cần đo là accuracy, final answer, output tokens, scratchpad tokens, latency, số lần gọi tool và cấu trúc của reasoning.
import time


def run_with_tool_loop(question, effort, tool):
    # Bước 1: ép model gọi tool
    r1 = call(question, effort, tool, force=True)
    fc = next(o for o in r1.output if o.type == "function_call")

    # Bước 2: trả về "OK" cố định, để model tự chọn tool (auto) và trả lời
    r2 = client.responses.create(
        model=MODEL,
        previous_response_id=r1.id,
        input=[{"type": "function_call_output", "call_id": fc.call_id, "output": "OK"}],
        reasoning={"effort": effort},
        tools=[tool],
        tool_choice="auto",
        include=["reasoning.encrypted_content"],
    )
    tokens = r1.usage.output_tokens + r2.usage.output_tokens
    return fc.arguments, r2.output_text, tokens


def evaluate(problems, effort, use_scratchpad):
    stats = {"correct": 0, "output_tokens": 0, "latency_s": 0.0}
    for p in problems:  # p = {"question": "...", "answer": "131/190"}
        t0 = time.time()
        if use_scratchpad:
            _, answer, tokens = run_with_tool_loop(p["question"], effort, SCRATCHPAD)
        else:
            r = call(p["question"], effort)
            answer, tokens = r.output_text, r.usage.output_tokens
        stats["latency_s"] += time.time() - t0
        stats["output_tokens"] += tokens
        stats["correct"] += p["answer"] in answer
    return stats


for effort in ["minimal", "medium"]:
    for use_scratchpad in [False, True]:
        print(effort, use_scratchpad, evaluate(PROBLEMS, effort, use_scratchpad))
7. Scratchpad có giúp model giải tốt hơn không?
Theo tôi đây mới là experiment đáng quan tâm nhất. Ví dụ minh họa (các con số 70% và 80% dưới đây chỉ là giả định để mô tả cách đọc kết quả, không phải kết quả đo thực tế): nếu GPT-5 với minimal reasoning đạt 70%, còn khi thêm scratchpad đạt 80%, thì chúng ta có một observation thú vị: model có thể đang dùng externalized reasoning như một workspace khi native reasoning bị giới hạn.
Điều này khác với việc chỉ yêu cầu "hãy giải thích câu trả lời của bạn", vì explanation chỉ xuất hiện sau khi model đã giải xong. Còn nếu tool call thực sự nằm giữa các bước inference, flow sẽ là: reason, ghi scratchpad, đọc lại scratchpad, tiếp tục reasoning, rồi trả lời. Nếu accuracy thực sự tăng, scratchpad không chỉ là cách "in reasoning ra màn hình" mà có thể đóng vai trò external working memory.
Một lưu ý nữa từ paper: model mạnh hơn không nhất thiết externalize nhiều reasoning hơn. Paper còn phân tích token efficiency, các loại reasoning step, branching, reasoning tree và khả năng transfer reasoning giữa các model. Vì vậy tôi không dùng số lượng reasoning-like tokens trong tool call làm proxy đơn giản cho việc "model reasoning nhiều hay ít": một model có thể thực hiện nhiều computation nhưng chỉ verbalize một phần rất nhỏ.
8. Kết luận
Experiment này khá nhỏ, nhưng cho tôi một observation rõ ràng: việc native reasoning bị ẩn không có nghĩa là model không thể tạo ra reasoning-like text ở một channel khác. Chỉ với một custom tool, GPT-5 tạo ra intermediate text trong tool arguments, trong khi native reasoning item vẫn encrypted.
Nhưng tôi không nghĩ nên gọi đây là "extract hidden CoT". Cách mô tả chính xác hơn là: một API-level mechanism khiến GPT-5 externalize một reasoning-like trace trong tool arguments. Hai khái niệm này khác nhau.
Experiment tiếp theo cũng không nên tập trung vào việc đọc encrypted_content. Hai câu hỏi đáng quan tâm hơn là: externalized reasoning có thực sự cải thiện computation không, và scratchpad có được model dùng một cách causal để đi đến final answer hay không. Nếu có, tool calling không còn chỉ là cách để "nhìn thấy reasoning", mà có thể trở thành một external computation workspace cho reasoning model.
Nguồn: Luo et al., Capable yet Parsimonious: Extracting and Characterizing Hidden Chain-of-Thought in Frontier Models, arXiv:2609.26637, September 2026.