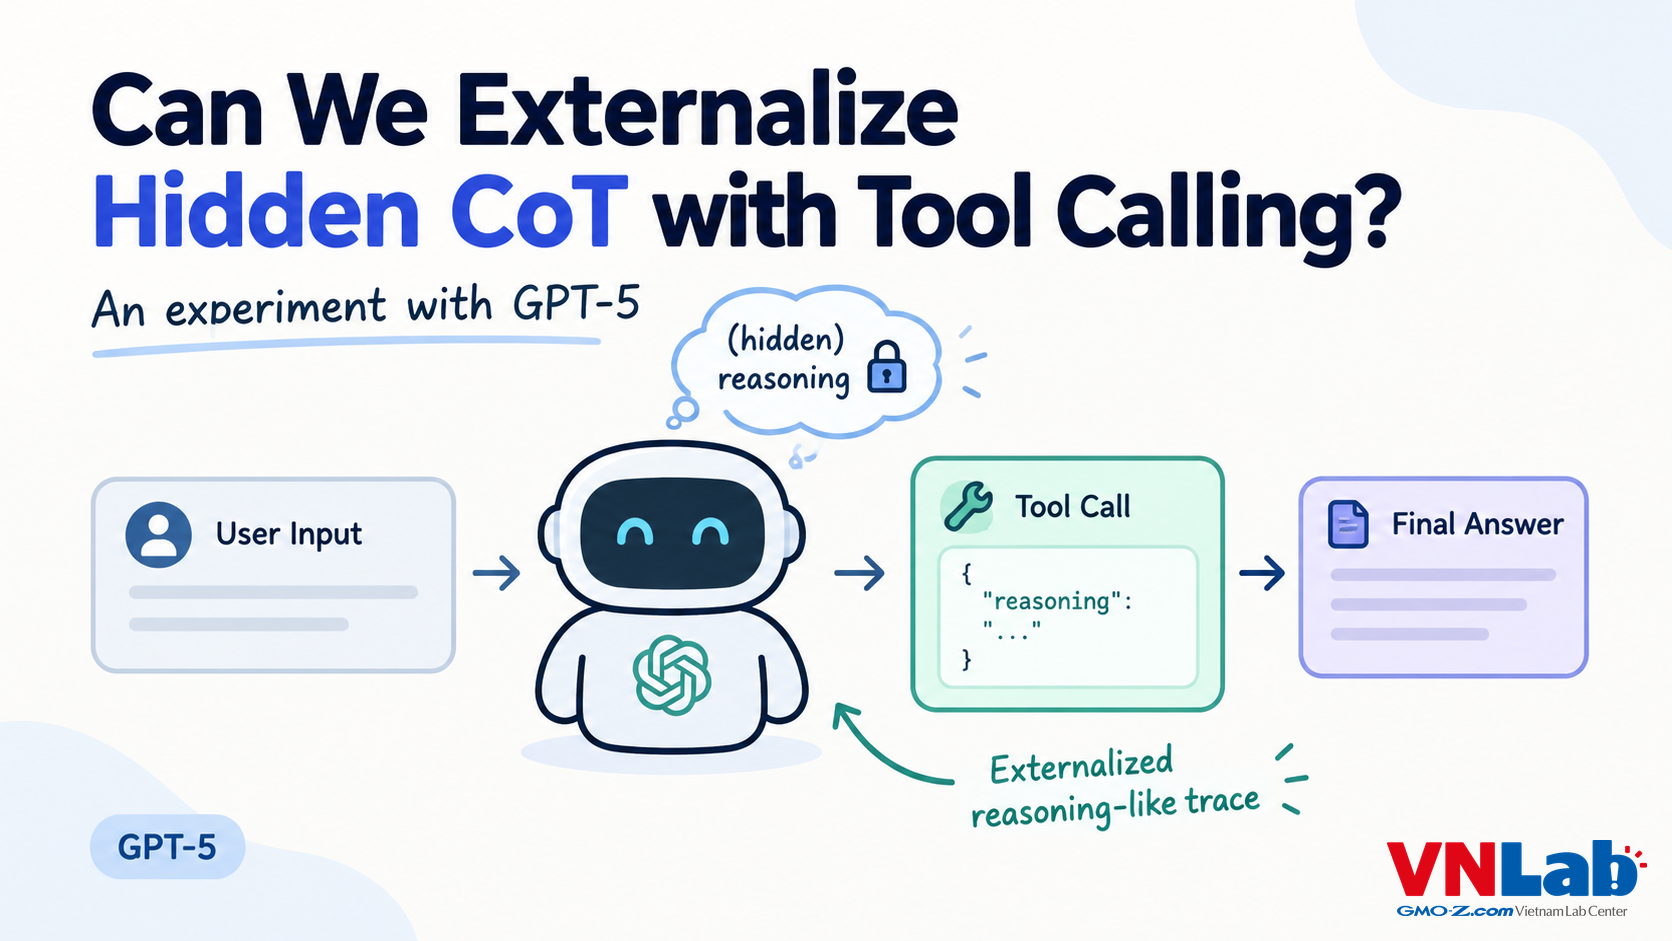
Gần đây tôi đọc một paper có tên Capable yet Parsimonious: Extracting and Characterizing Hidden Chain-of-Thought in Frontier Models [https://arxiv.org/abs/2609.26637]. Ý tưởng chính của paper khá đơn giản nhưng khiến tôi tò mò: Nếu reasoning của một model bị ẩn, liệu chúng ta có thể khiến model tự đưa một phần reasoning ra ngoài thông qua một custom tool hay không? Tôi thử ý tưởng này với GPT-5 thông qua OpenAI Responses API. Kết quả không phải là tôi "lấy được hidden Chain-of-Thought" của GP ... »