Tản mạn
Hẹ hẹ, chào anh em!
Chắc anh em nào gần đây tích hợp AI vào quy trình CI/CD hay dùng các công cụ AI coding agent như Claude Code, Codex để tự động review code đều từng nếm trải cảm giác vừa mừng vừa… ức chế (haizz).
Mừng là vì bot phản hồi nhanh như chớp, vừa tạo Pull Request (PR) xong là 30 giây sau đã thấy thông báo ting ting. Nhưng mở ra đọc thì hỡi ôi:
- Một PR sửa đúng 3 dòng logic fix bug gấp thì bot nhảy vào yêu cầu: “Bạn nên refactor lại toàn bộ module này theo Clean Architecture, tách 5 interface và viết bổ sung 12 unit test bao phủ 100%…” (ảo ma thực sự).
- Vòng review 1 dev đã sửa xong các issue quan trọng, push commit mới lên thì bot lại… đẻ thêm 5 cái góp ý lặt vặt về cách đặt tên biến và thụt lề mà vòng trước nó không hề nhắc tới.
- Dev vào comment giải thích lý do tại sao đoạn đó phải viết như vậy, vòng sau bot vào review tiếp và… lặp lại y nguyên nhận xét cũ như chưa hề có cuộc chia ly (sad).
Cuối cùng, thay vì giúp tăng tốc độ phát triển, con bot AI trở thành một “bà mẹ chồng khó tính” soi từng cọng rác, gây tắc nghẽn toàn bộ luồng merge code của anh em. (Bottleneck)
Tại hội thảo AI Engineer World’s Fair, hai kỹ sư của Uber (Will Bond & Ameya Ketkar) đã công bố hệ thống uReview — Dùng Multi-Agent Code Review xử lý hơn 25.000 comments mỗi tuần. Và khi đối chiếu bài toán của Uber với chính trải nghiệm thực tế từ các dự án mình tham gia trong thời đại AI hiện nay, mình nhận ra: Tất cả chúng ta đều đang vấp phải những cái bẫy y hệt nhau khi để AI review code.
Hôm nay, mình cùng anh em mổ xẻ từ kiến trúc cấp enterprise của Uber cho đến những kinh nghiệm thực chiến để thuần hóa AI Review thành một trợ thủ đắc lực thay vì một máy spam comment rác.
1. Nỗi đau chung: Khi AI trở thành nút thắt cổ chai của PR
Tại Uber, với quy mô hàng nghìn kỹ sư trên 6 monorepo khổng lồ, khi AI coding tools bùng nổ, lượng code sinh ra tăng vọt khiến thời gian chờ review đầu tiên (Time to First Review) tăng từ 3 giờ (2024) lên tới 9 giờ (2026).
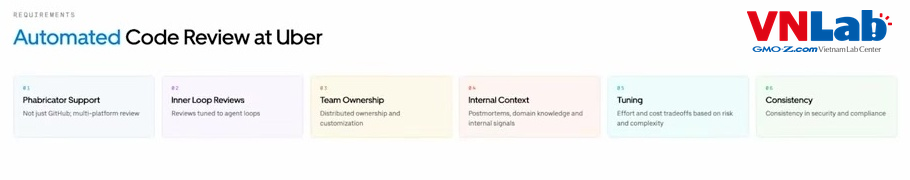
Nhưng ở chiều ngược lại, khi anh em vội vã cắm một con bot AI đơn lẻ vào để “chữa cháy”, một loạt vấn đề nhức nhối xuất hiện:
Bẫy 1: False Positive & “Chủ nghĩa hoàn hảo” viển vông
- Quá strict: Bot đánh giá code theo tiêu chuẩn “sách giáo khoa”, đòi hỏi sự hoàn hảo lý thuyết thay vì tính thực tế của dự án.
- Over-engineering: Một thay đổi nhỏ (hotfix) bị đòi hỏi phải tái cấu trúc toàn diện, thêm thắt các pattern không cần thiết.
- Áp dụng best practice chung chung: Không hiểu bối cảnh riêng của codebase, đưa ra các đề xuất xung đột với convention nội bộ của team.
Bẫy 2: Review lặp lại & Spam nhiễu loạn (Noisy Loops)
- Lặp lại comment cũ: Không đọc được ngữ cảnh trao đổi trong thread comment của GitHub/GitLab.
- Soi nits ngoài scope: Nhảy vào bắt lỗi ở những file hoặc những dòng code không hề bị sửa trong PR hiện tại.
- Đẻ thêm feedback mới liên tục: Mỗi lần dev push commit fix lỗi chính, bot lại “ngứa tay” tìm thêm lỗi phụ, khiến PR rơi vào vòng lặp review vô tận không bao giờ được approve.
2. Kiến trúc uReview của Uber: Đừng bắt một con Bot làm mọi thứ
Ví von: Một bác bảo vệ gác cổng vs. Hội đồng chuyên môn có bộ lọc
Nếu anh em chỉ quăng diff code vào một prompt duy nhất của Claude hay GPT, điều đó giống như việc anh em thuê một bác bảo vệ đứng gác cổng và bắt bác ấy vừa phải kiểm tra thẻ nhân viên, vừa soi lỗi chính tả tài liệu, vừa thẩm định bản vẽ kết cấu chịu lực của tòa nhà. Bác ấy chắc chắn sẽ hoa mắt và phán bừa.
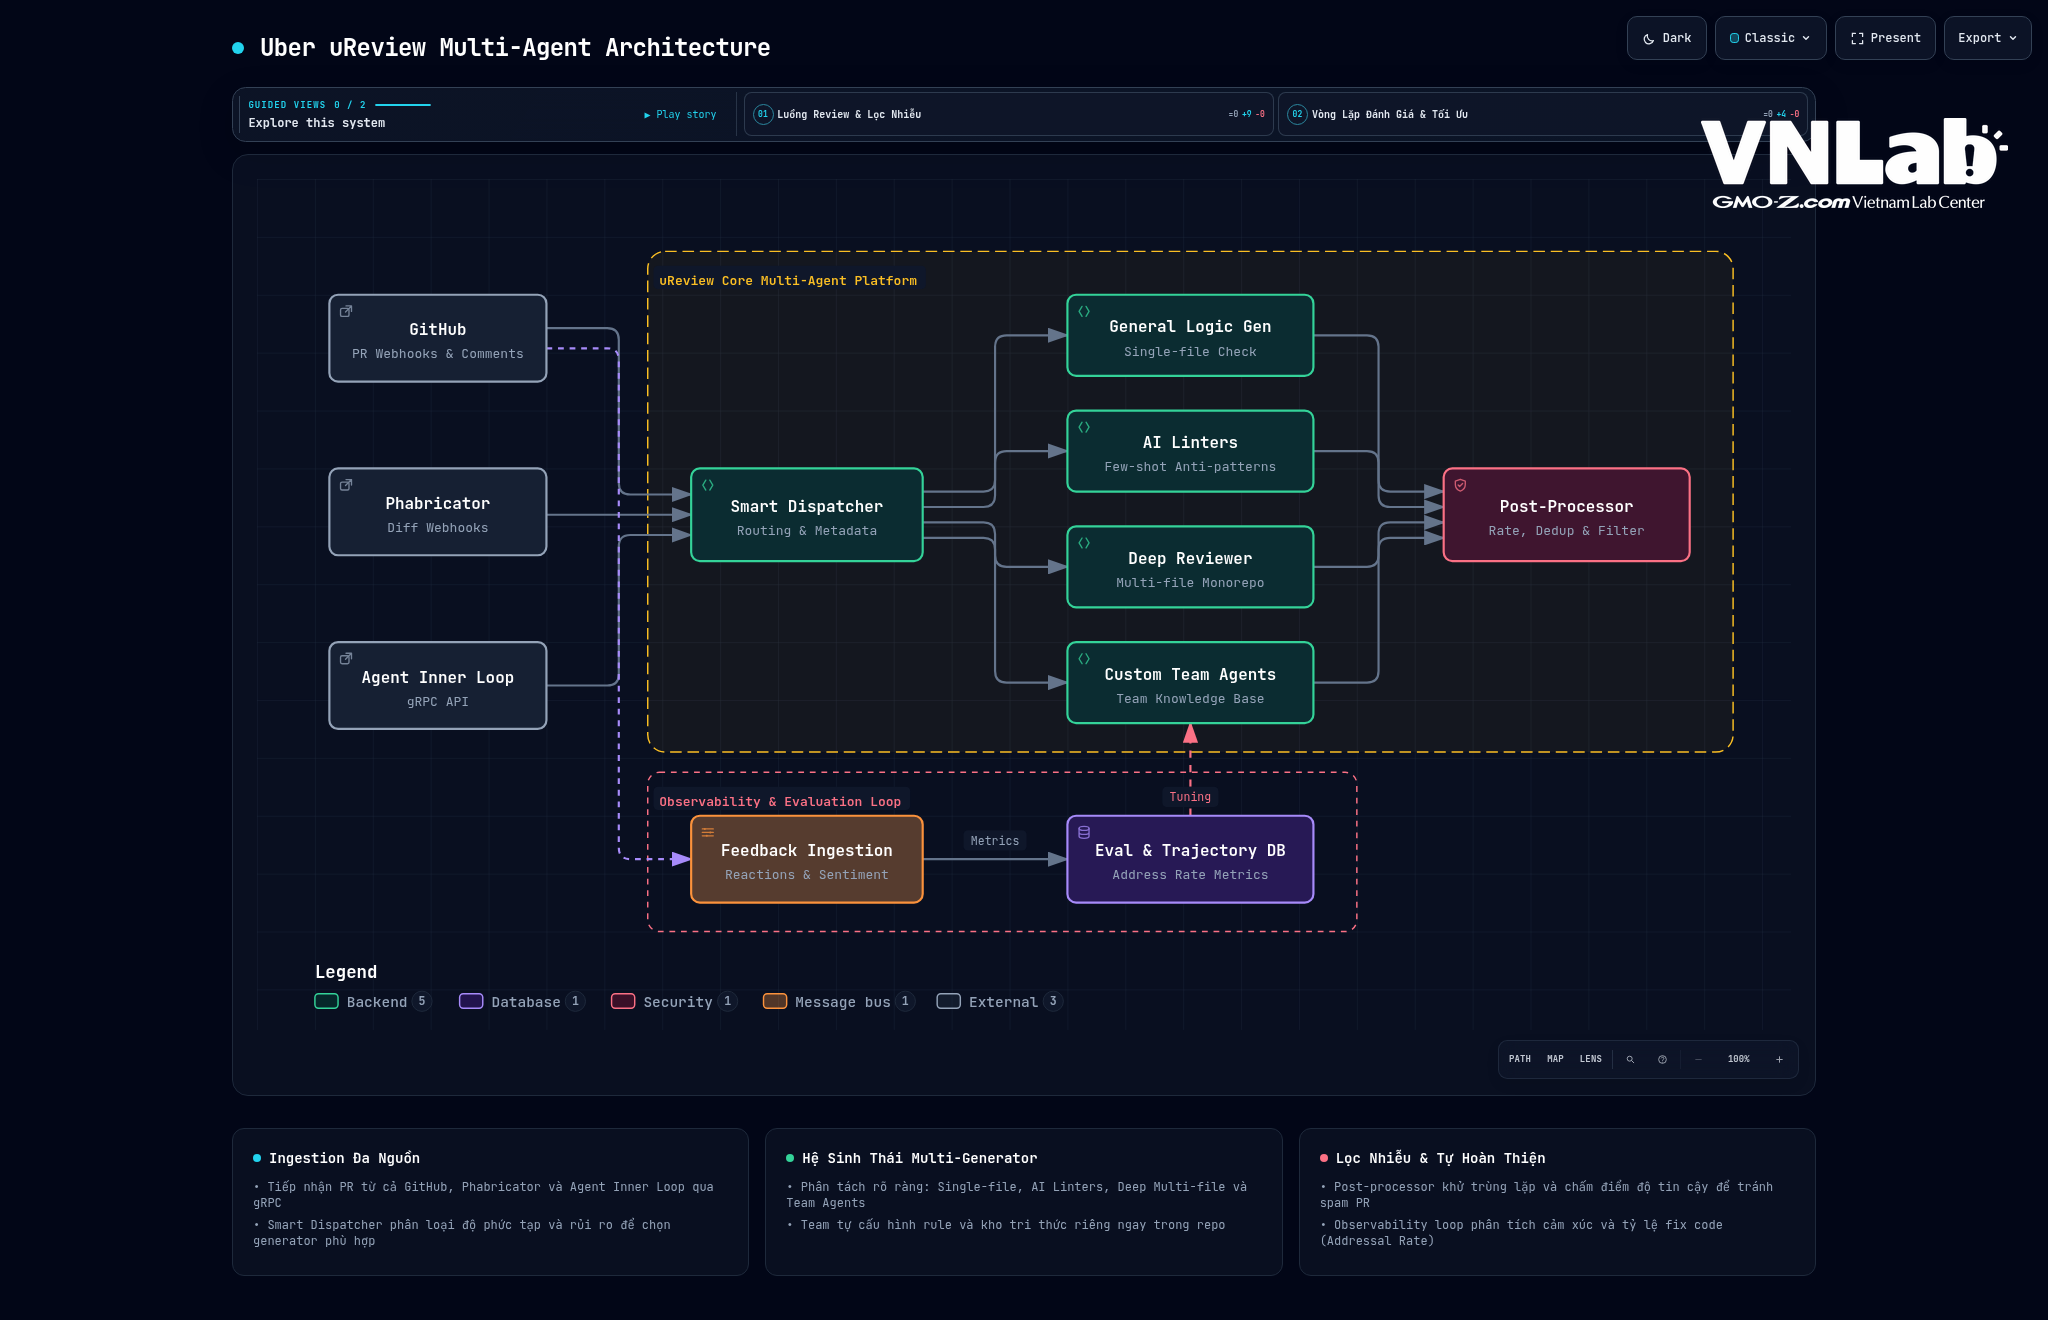
Uber giải quyết việc này bằng mô hình Multi-Agent kết hợp Bộ lọc hậu xử lý (Post-Processing):
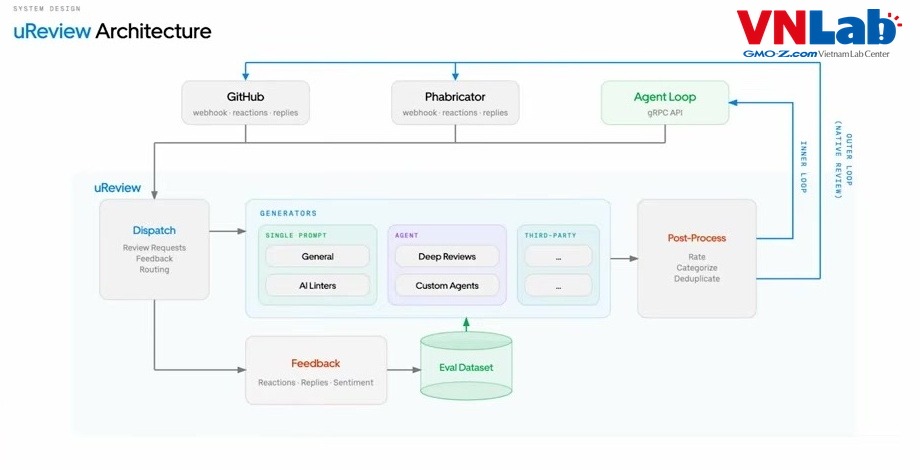
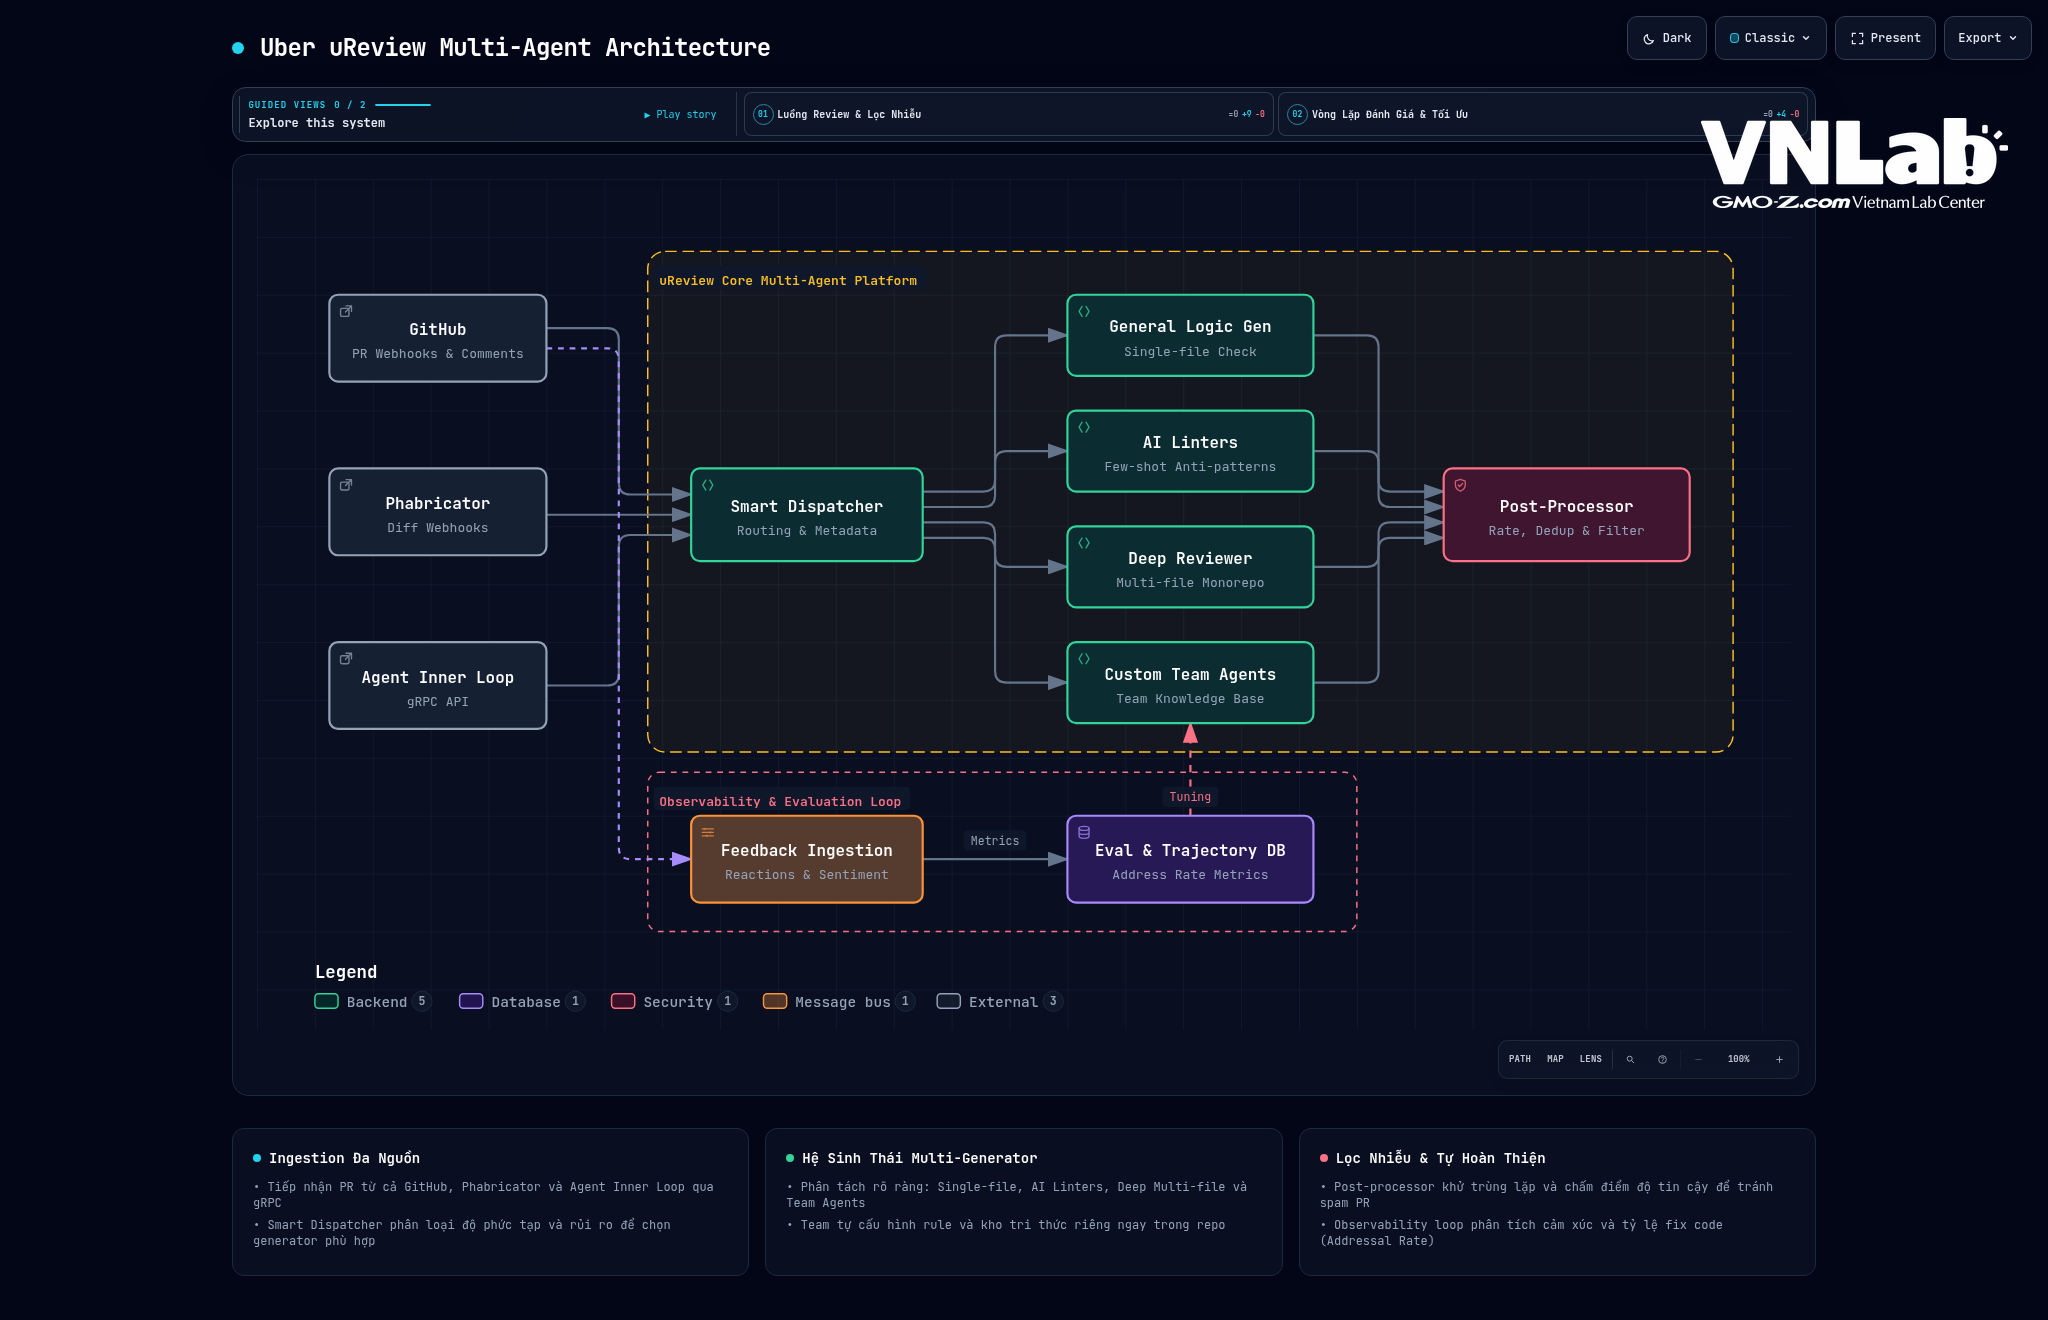
Nhân tiện architecture này mình vẽ bằng skill này: https://github.com/tt-a1i/archify, cũng khá hay và tiện.
Tiếp nào:
Bí quyết cốt lõi từ Uber:
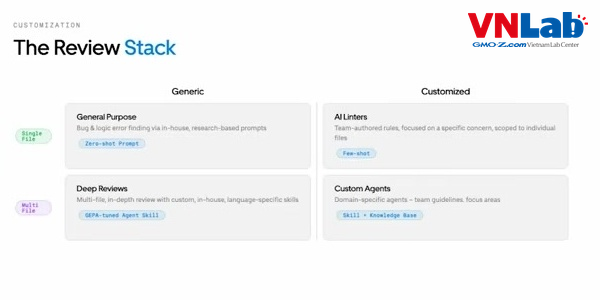
Chia nhỏ generator (The Review Stack): Tách riêng prompt bắt lỗi logic, AI linter bắt quy chuẩn cú pháp, và agent chuyên sâu đọc tài liệu dự án monorepo, lấy context xung quanh.
- Post-Processing (Bộ lọc khử trùng lặp): Khi nhiều generator cùng chạy, lượng nhận xét trùng nhau rất lớn. Bước hậu xử lý sẽ xếp hạng độ tin cậy (Confidence Score) và khử trùng lặp. Chỉ những nhận xét có độ tự tin cao và thực sự có giá trị hành động mới được hiển thị cho dev.
- Observability ghìm cương LLM: Đo lường Addressal Rate (tỷ lệ dev thực sự sửa code theo comment) và Sentiment Analysis (phản ứng vui vẻ hay tức giận của dev) để loại bỏ các prompt vô dụng.
Nhờ các cơ chế quan sát và đánh giá này, Uber đã đạt được những con số cực kỳ ấn tượng:
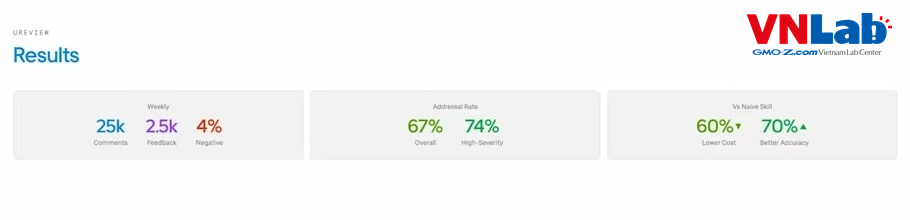
- Chi phí vận hành giảm 60%, chất lượng & độ chính xác tăng 70%.
- Tỷ lệ giải quyết nhận xét (Addressal Rate) đạt 67%, với lỗi nghiêm trọng đạt tới ~74%.
- Tỷ lệ nhận phản hồi tiêu cực trên toàn công ty chỉ còn 4%.
3. Bài học thực chiến: Tối ưu luồng Review-in-Loop cho dự án thật
Từ mô hình của Uber kết hợp với kinh nghiệm triển khai, trải nghiệm thực tế của bản thân qua các dự án dùng Full AI Review, Full AI Coding của mình , dưới đây là bộ khung giải pháp giúp anh em dẹp tan hoàn toàn tình trạng review rác.
3.1. Phân tách hai luồng độc lập: Spec Conformance vs. Code Quality
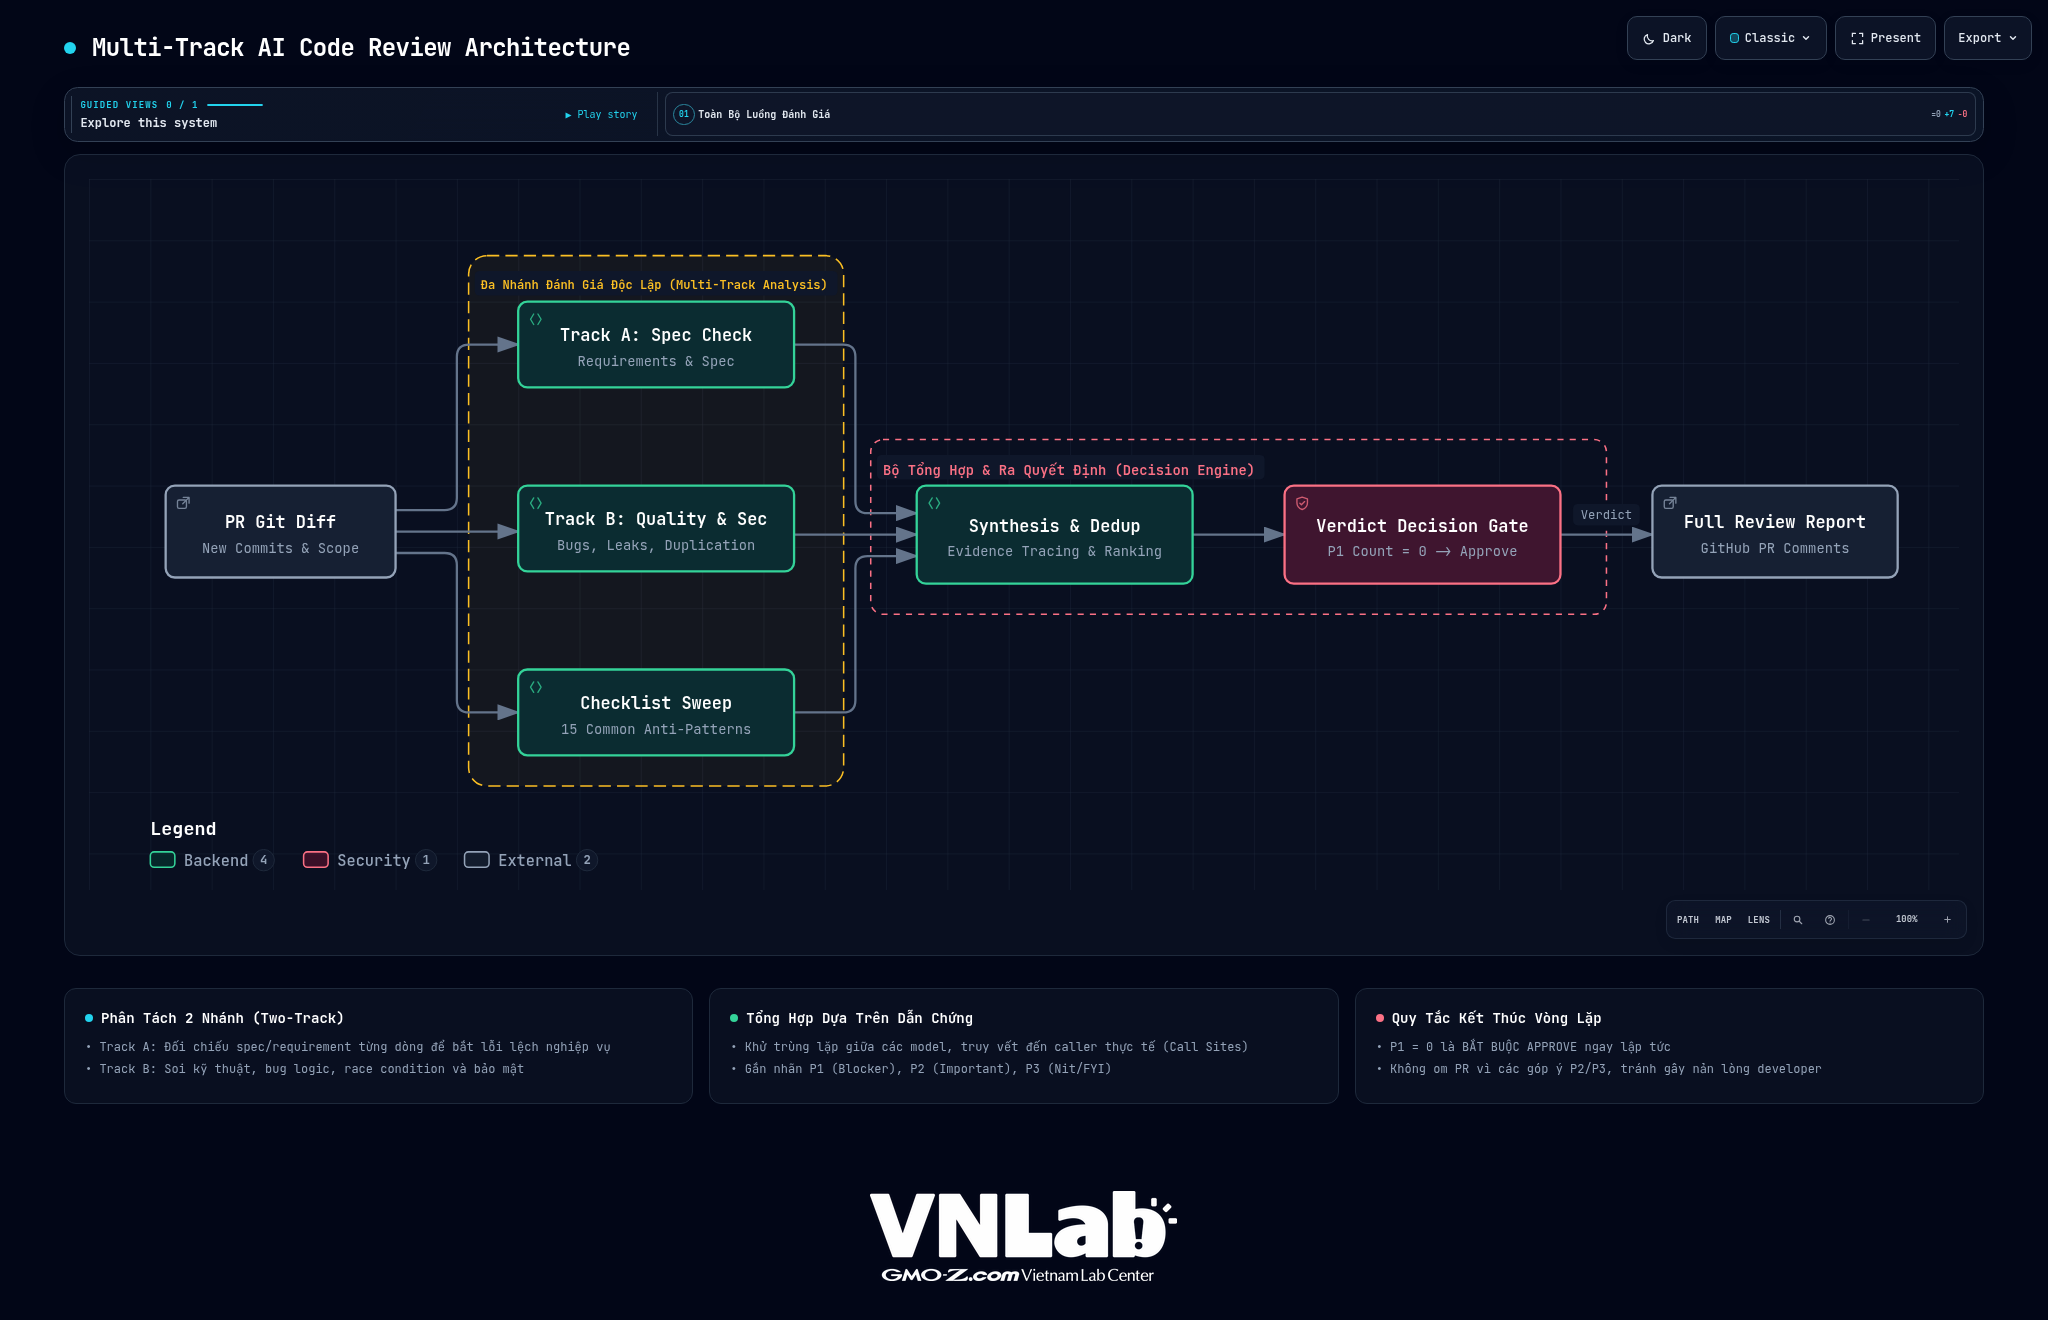
Đừng bắt một model vừa đọc hiểu tài liệu requirement vừa soi bug thuật toán. Hãy chia làm 2 Track rõ ràng:
- Track A — Kiểm tra tính tương thích đặc tả (Spec Conformance): Đọc file requirement/spec hoặc Acceptance Criteria của Task/Issue, đối chiếu từng dòng diff xem code có đáp ứng đúng nghiệp vụ hay không. Phần lớn các lỗi P1 nghiêm trọng trong thực tế xuất phát từ việc lệch spec chứ không phải lỗi cú pháp.
- Track B — Kiểm tra chất lượng code & bảo mật: Chuyên tâm rà soát bug logic, race condition, lỗ hổng SQL/XSS, trùng lặp code và vấn đề performance.
Hai track này sau đó được tổng hợp (Synthesis) lại, lọc bỏ trùng lặp trước khi xuất ra kết quả cuối cùng.
3.2. Phân loại mức độ nghiêm trọng (Severity Taxonomy) và Điều kiện Approve rõ ràng
Một sai lầm phổ biến là coi mọi nhận xét đều bình đẳng như nhau. Cần thiết lập ranh giới rõ ràng:
- [P1] Blocker (Bắt buộc sửa): Lỗi sai lệch requirement, bug logic nghiêm trọng gây crash, lỗ hổng bảo mật, hỏng tương thích ngược. Có P1 là Request Changes, cấm merge.
- [P2] Important (Nên sửa): Thiết kế dễ vỡ (fragile), thiếu xử lý edge-case, nguy cơ chậm query nhưng chưa chết ngay.
- [P3] Nit / Minor (Tham khảo): Đặt tên biến chưa hay, gợi ý refactor cho đẹp, cách viết ngắn hơn. Tuyệt đối không bao giờ chặn PR vì lỗi P3.
Nguyên tắc vàng để kết thúc vòng lặp (Loop Termination): Khi số lượng lỗi [P1] = 0, hệ thống BẮT BUỘC PHẢI APPROVE. Toàn bộ các góp ý P2/P3 chỉ mang tính chất ghi chú (FYI) hoặc chuyển thành ticket cải tiến sau. Không được phép giữ PR làm con tin vì những góp ý mức độ thấp.
3.3. Cơ chế Context-Aware Re-Review (Chống lặp lại khi review vòng sau)
Để tránh tình trạng bot bị “mất trí nhớ” và comment lại những thứ dev đã giải thích:
- Giới hạn phạm vi (Scope Discipline): Ở các vòng review sau (follow-up rounds), bot chỉ được phép đọc các commit mới được push lên. Tuyệt đối không xới lại những đoạn code cũ đã duyệt ở vòng trước.
- Đọc lịch sử thảo luận (Thread History): Trước khi xuất nhận xét, bot phải đọc các reply của developer trong thread. Nếu dev đã phản hồi lý do giữ nguyên thiết kế hoặc chấp nhận rủi ro có chủ đích, bot phải ghi nhận và không được lặp lại góp ý đó.
- Bảng trạng thái xử lý rõ ràng: Tạo bảng so sánh đối chiếu:
- Issue cũ 1: Đã khắc phục (Resolved) — kèm dẫn chứng commit/line code.
- Issue cũ 2: Chưa khắc phục (Unresolved) — chỉ nhắc lại nếu là P1.
3.4. Chiến thuật “Song kiếm hợp bích” Codex x Claude Code (Cross-Model Multi-Review)
Một trong những bước tiến thực chiến mạnh mẽ gần đây là việc OpenAI chính thức phát hành Codex plugin cho Claude Code (openai/codex-plugin-cc). Sự kết hợp này mang lại mô hình Cross-Model Validation (Review chéo giữa 2 AI Model khác họ) ngay trong cùng một phiên làm việc CLI.
Tại sao một model tự code rồi tự review lại kém hiệu quả?
- Điểm mù của Claude (Opus / Sonnet): Rất xuất sắc trong việc lập kế hoạch tổng thể (Plan mode), hiểu ngữ cảnh sâu và refactor linh hoạt, nhưng lại hay có xu hướng over-engineering (vẽ ra kiến trúc cồng kềnh cho task nhỏ), ngốn token và dễ có “thiên kiến tự xác nhận” (confirmation bias) với code chính mình vừa sinh ra.
- Điểm mạnh của Codex (GPT-5.6): Được trang bị năng lực reasoning và giải quyết (solve) các bài toán kỹ thuật phức tạp vượt bậc, dẫn đầu ở các benchmark thực tế như SWE-bench Pro — thước đo sát sườn nhất về năng lực bóc tách lỗi logic ngầm và phân tích diff hóc búa. Thêm vào đó, chi phí token tối ưu hơn đáng kể cùng tốc độ xử lý nhanh giúp Codex trở thành “cỗ máy quét lỗi” lý tưởng để gánh tải review liên tục mà không lo đội chi phí.
Luồng phối hợp 3 bước thực chiến:
- Claude Code (Tác giả): Đảm nhận vai trò Author, tận dụng Plan mode để phân tích yêu cầu nghiệp vụ và viết code tính năng.
- Codex Plugin (Phản biện độc lập):
/codex:review: Review nhanh các thay đổi cục bộ (uncommitted changes) trước khi commit. Chế độ chỉ đọc (read-only), bắt lỗi logic tức thì mà không can thiệp sửa file./codex:adversarial-review: Phản biện chuyên sâu (Adversarial Review) đối với các thay đổi phức tạp. Codex sẽ đóng vai một Reviewer nghiêm khắc để soi xét thiết kế, bóc tách edge-case và phân loại mức độ nghiêm trọng (P1/P2/P3).
Claude Code (Khắc phục & Chuẩn hóa): Claude đọc danh sách issue từ Codex, đối chiếu lại với spec nghiệp vụ ban đầu để fix triệt để các lỗi P1/P2 trước khi đẩy PR lên CI/CD.
# 1. Thêm marketplace của OpenAI vào Claude Code
/plugin marketplace add openai/codex-plugin-cc

# 2. Cài đặt plugin Codex
/plugin install codex@openai-codex

# 3. Kết nối tài khoản ChatGPT (hỗ trợ cả tài khoản Free/Plus)
/codex:setup
Tip thực chiến: Đối với các thay đổi đa file (multi-file), việc review sâu có thể mất từ 1-3 phút. Hãy chọn chế độ Run in background và dùng /codex:status để theo dõi tiến độ, tránh ngắt quãng luồng tư duy khi đang làm việc.4. Hiện tượng “Cavitation” trong Inner Loop và tương lai của Dev
Ví von: Tài xế chạy theo Google Maps bị trễ 5 phút
Khi đưa AI vào cả 2 đầu: AI tự code và AI tự review trong nội bộ (Inner Loop), hiện tượng nguy hiểm nhất là Agent Cavitation (Vòng xoáy lú lẫn).
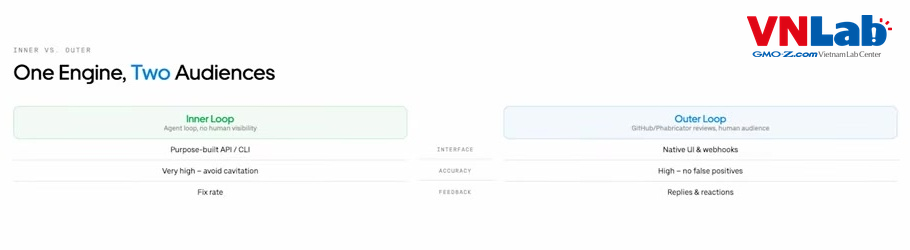
Hãy tưởng tượng anh em lái xe theo một app bản đồ bị delay. Vừa rẽ trái xong, app bảo “Hãy quay đầu lại”. Quay đầu xong, nó lại bảo “Hãy rẽ trái”. Cứ thế anh em chạy lòng vòng quanh bùng binh mà không bao giờ tới đích.
Khi AI Review đưa ra nhận xét sai hoặc quá khắt khe, Coding Agent sẽ tin lời, sửa code làm hỏng logic cũ, rồi lại bị con Review Agent khác bắt lỗi mới… Vòng lặp này đốt sạch token và làm nát bét cả codebase.
AI có “cướp việc” của Software Engineer?
AI có “cướp việc” của Software Engineer?
Không. AI không giết chết quy trình review của con người, mà nó nâng tầm trách nhiệm của kỹ sư lên một nấc mới (Expanding the Outer Loop):
- AI Agent: Gánh toàn bộ các công việc chân tay tẻ nhạt: bắt lỗi cú pháp, kiểm tra spec cơ bản, rà soát type/linting, tối ưu hóa vi mô.
- Kỹ sư phần mềm: Được giải phóng khỏi hàng giờ căng mắt soi từng dấu chấm phẩy, chuyển toàn bộ sự tập trung sang Kiến trúc hệ thống (Architecture), Tư duy sản phẩm (Product Thinking) và Nghiệp vụ đặc thù (Domain Expertise).
BÀI HỌC KINH NGHIỆM
Từ case study của Uber và kinh nghiệm tự tối ưu luồng review-code, mình đúc kết lại 5 nguyên tắc sống còn:
- Review dựa trên bằng chứng (Evidence-Based), không đoán mò: Mọi cảnh báo bug phải trace được ra call site thực tế. Nếu một đoạn code chỉ “có vẻ hơi nguy hiểm” nhưng hiện tại không có caller nào kích hoạt lỗi, hãy gắn nhãn P3 (Fragile) chứ đừng biến nó thành P1 blocker.
- Khuôn khổ rõ ràng cho PR nhỏ: PR dưới 50 dòng thì cấm tiệt bot gợi ý refactor lớn hay bắt viết thêm cả hệ thống test phức tạp. Tránh tuyệt đối over-engineering.
- P1 = 0 là Approve ngay: Giữ vững kỷ luật kết thúc vòng lặp. Không om PR vì những góp ý “nice-to-have”.
- Tôn trọng phản hồi của Developer: Luồng review phải biết đọc thread comment cũ để hiểu tại sao dev lại chọn giải pháp đó thay vì cứ lặp lại một bài ca máy móc.
- Observability là chìa khóa: Luôn theo dõi xem team có thực sự tiếp thu comment của bot hay đang bấm dismiss hàng loạt. Bot sinh ra để phục vụ team, không phải để làm phiền team.
Kết luận
AI Code Review không phải là một chiếc đũa thần cắm vào là xong, mà là một hệ thống kỹ thuật đòi hỏi sự tinh chỉnh cẩn trọng giữa độ nhạy (precision) và độ bao phủ (recall).
Khi anh em biết cách tổ chức đa luồng (Multi-Track), thiết lập bộ lọc khử nhiễu (Deduplication) và xác định điều kiện dừng thông minh, AI sẽ trở thành một người cộng sự đắc lực giúp giải phóng toàn bộ năng lượng của team để tập trung vào những bài toán kiến trúc lớn hơn.
Hy vọng bài viết này giúp anh em có thêm góc nhìn thực tế để thiết kế hoặc tinh chỉnh lại con bot review code cho dự án của mình. Còn một chủ đề cực kỳ hay nữa mà anh em cũng nên đào sâu là Automated Merge Gates & CI/CD Governance — cách kết hợp AI review với pipeline tự động deploy an toàn (nhớ tìm hiểu thêm nhé!).
Nguồn tham khảo:
- AI Engineer World’s Fair — Building uReview, Uber’s Multi-Agent Code Review Engine (Will Bond & Ameya Ketkar, Uber)
- Codex plugin for Claude Code: Why, when, and how you should use it in the product design process (Nick Babich, UX Planet)
- Uber Engineering Blog