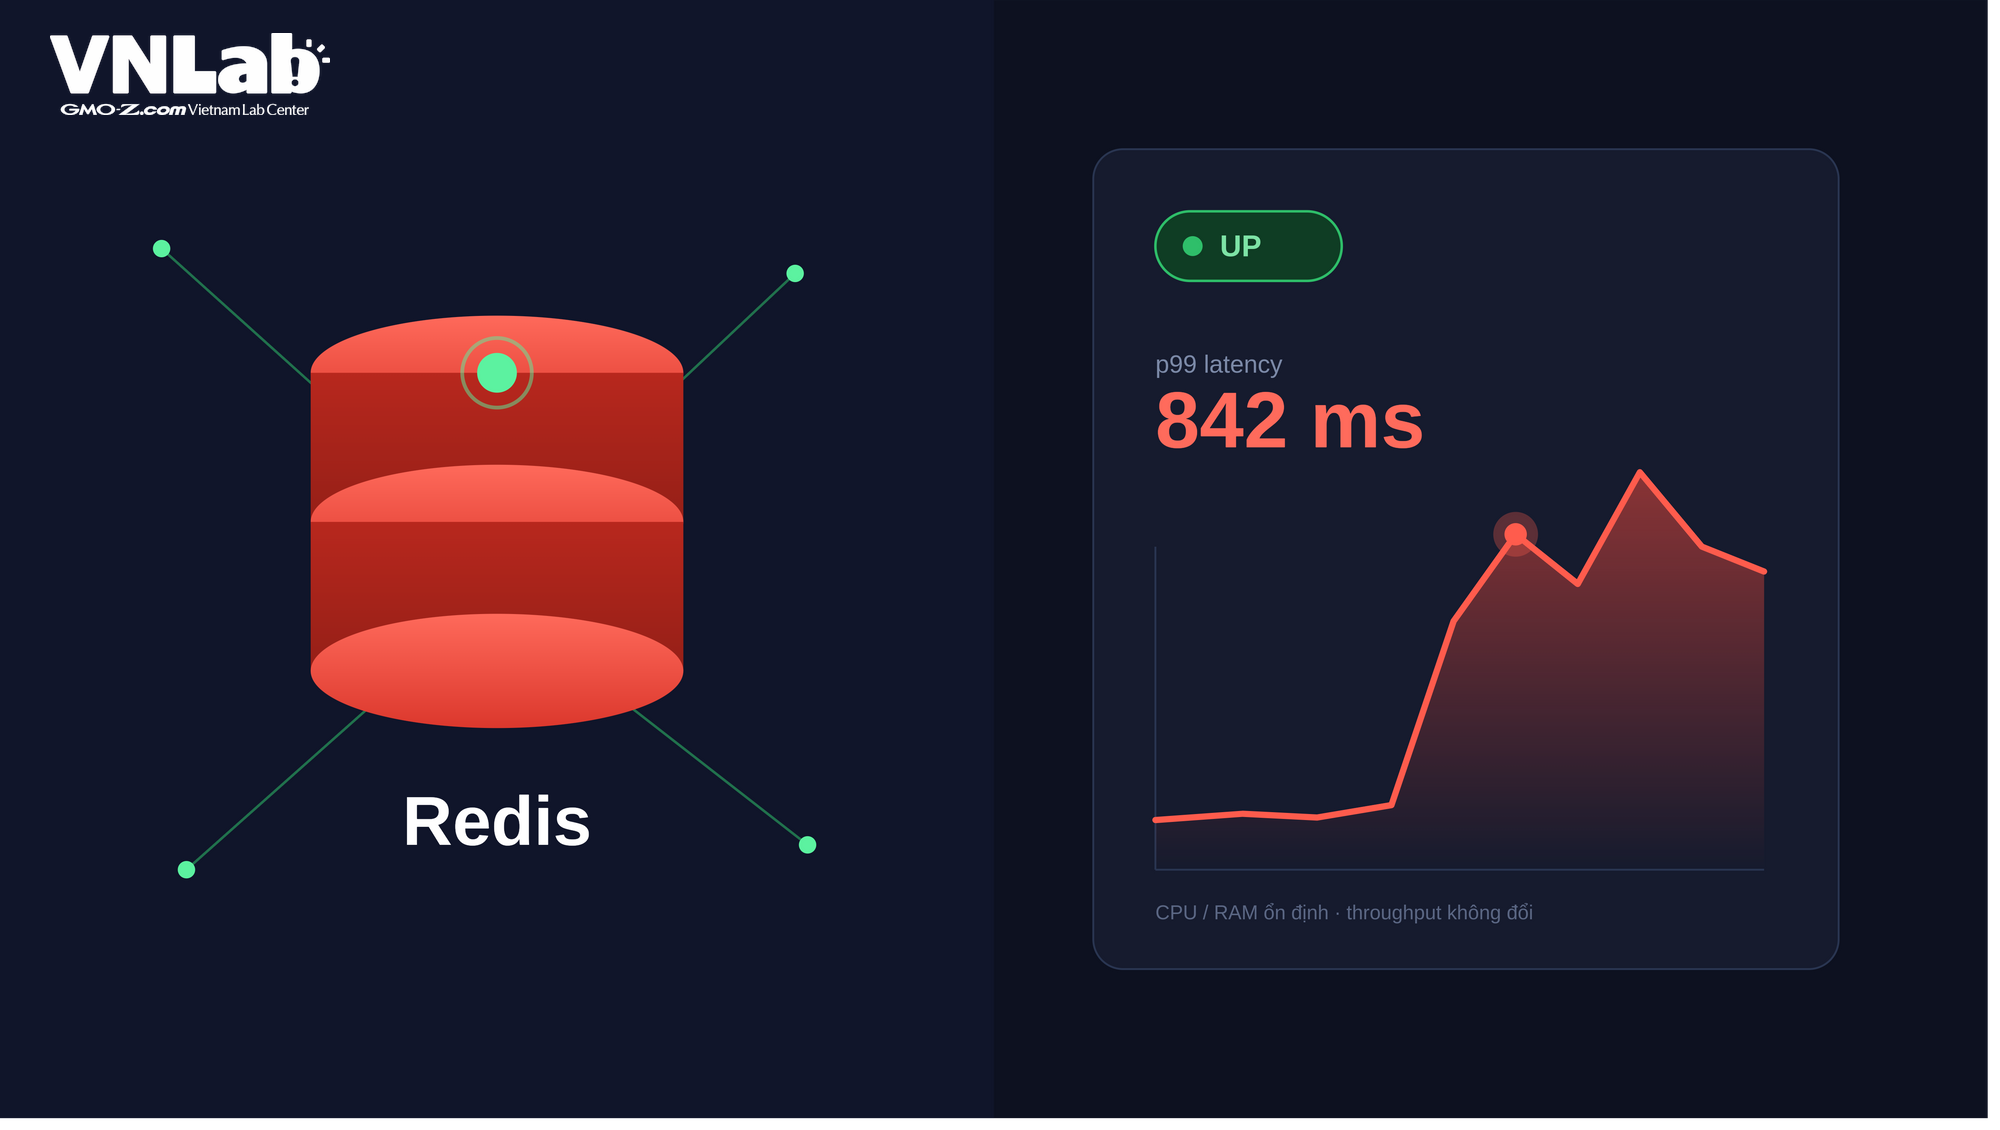
Redis vẫn UP nhưng Latency vẫn tăng vọt: Vấn đề nằm ở đâu?
1. Vậy vấn đề này là gì?
Nhiều team dùng redis-cli PING hoặc metric redis_up = 1 để kết luận Redis "khỏe". Tuy nhiên, PING chỉ trả lời một câu hỏi: Redis còn phản hồi hay không. Nó không trả lời câu hỏi quan trọng hơn: Redis đang phản hồi nhanh hay chậm.
Ví dụ minh họa:
$ redis-cli -h prod-redis-01 PING
PONG

$ redis-cli -h prod-redis-01 --latency-history -i 5
min: 1 ms, max: 3 ms, avg: 1.42 ms
...
min: 1 ms, max: 4180 ms, avg: 210 ms
Trong trường hợp này, Redis vẫn luôn trả về PONG, nhưng độ trễ phản hồi (response latency) đã tăng từ khoảng 1 ms lên hơn 4 giây. Đó chính là khác biệt giữa process alive và system healthy.
Tại sao đây là vấn đề lớn?
Redis xử lý hầu hết command trên một event loop đơn luồng. Mọi request — kể cả GET đơn giản nhất — đều phải chờ đến lượt nếu luồng chính đang bận.
Những nguyên nhân phổ biến khiến latency tăng gồm:
- Các command có độ phức tạp cao trên tập dữ liệu lớn (
HGETALL,SMEMBERS,KEYS…) - Quá trình
fork()khi tạo snapshot RDB (BGSAVE) hoặc AOF rewrite (fork chỉ diễn ra ngắn nhưng có thể gây pause) - Việc xóa hoặc hết hạn số lượng lớn key trong một thời điểm (expire/deletion burst)
Khi luồng chính bị chiếm dụng, request không nhất thiết lỗi ngay. Chúng sẽ tiếp tục xếp hàng và chờ được xử lý. Nếu thời gian chờ vượt quá timeout của client hoặc upstream, kết quả mới xuất hiện dưới dạng timeout, 504 Gateway Timeout, hoặc làm cạn thread/connection pool ở tầng application.
Hai điểm cần lưu ý
fork()không chiếm dụng event loop suốt quá trìnhBGSAVERedis chỉ bị pause chủ yếu ở thời điểm gọifork(). Sau đó tiến trình con thực hiện việc ghi RDB, còn tiến trình chính vẫn tiếp tục xử lý request.- TTL expiration: Không phải mọi TTL đều gây spike. Vấn đề xảy ra khi có nhiều key hết hạn hoặc bị xóa cùng lúc, khiến Redis phải dành nhiều thời gian cho việc expire/deletion.
Vì sao Redis đặc biệt dễ gặp tình trạng này?
Vì kiến trúc single-threaded vốn là điểm mạnh của Redis (đơn giản, không cần lock, throughput cao cho workload nhỏ) lại chính là điểm yếu khi có một request "nặng" chen ngang. Không có core thứ hai nào đứng ra xử lý hộ.
- Trường hợp phổ biến nhất là fork() khi BGSAVE. Khi Redis tạo snapshot, kernel phải tạo page table cho tiến trình con dựa trên toàn bộ vùng nhớ đã cấp phát. Với instance có bộ nhớ rất lớn hoặc bật Transparent Huge Pages, thời gian fork() có thể kéo dài đến hàng giây. Trong thời điểm fork() này, Redis tạm dừng xử lý request, khiến latency tăng đột biến. Sau khi fork() hoàn tất, main thread tiếp tục hoạt động bình thường; việc ghi RDB sau đó được thực hiện bởi child process thông qua cơ chế copy-on-write.
Điều khiến tình trạng này cực kỳ nguy hiểm
Mọi chỉ số hạ tầng vẫn xanh. Đây mới là phần nguy hiểm thật sự:
- CPU tổng có thể vẫn thấp trên máy nhiều vCPU, vì Redis chủ yếu sử dụng một core cho event loop và latency spike do fork() không nhất thiết làm CPU toàn hệ thống tăng cao.
- RAM không nhất thiết tăng đột biến ngay khi fork() xảy ra, vì ban đầu parent và child chia sẻ các memory page thông qua Copy-on-Write. Tuy nhiên, trong quá trình ghi dữ liệu, các page bị thay đổi có thể được copy, khiến memory usage tăng.
- Alert redis_up không bao giờ bắn, vì tiến trình không hề chết.
- Nói cách khác: bộ chỉ số phổ biến nhất mà hầu hết team đang alert theo (uptime, CPU tổng, RAM tổng) chỉ trả lời được câu hỏi "tiến trình còn sống không", trong khi vấn đề thực sự nằm ở câu hỏi "tiến trình có đang bị chặn không". Hai câu hỏi khác nhau hoàn toàn, và phần lớn dashboard chưa bao giờ trả lời được câu thứ hai.
2. Giải pháp
Đo đúng chỉ số, đừng đo uptime
redis-cli INFO stats | grep fork
latest_fork_usec:5935total_forks:4
Lưu ý dễ nhầm: latest_fork_usec nằm ở section `stats`, không phải persistencenhư nhiều bài viết hay ghi (kể cả một vài bài trên chính redis.io ở version cũ). Đây là con số khớp với latency thực tế do fork gây ra, không phải redis_up.
Redis còn có sẵn cơ chế latency monitoring nội bộ, không cần đoán mò từ INFO:
redis-cli CONFIG SET latency-monitor-threshold 100
redis-cli LATENCY HISTORY forkredis-cli LATENCY DOCTOR
LATENCY DOCTOR tự phân tích các sự kiện nghẽn gần nhất và trả lời bằng mô tả rõ ràng (ví dụ: "Redis dành X% thời gian chờ fork") — nhanh hơn nhiều so với việc tự ghép INFOvới --latency-history.
Các kỹ thuật khác:
Tắt Transparent Huge Pages trên host chạy Redis — giảm trực tiếp thời gian fork().
Chuyển lịch BGSAVE sang replica, tắt snapshot tự động trên primary.
Cấp RAM sát với dataset thực tế — Cấp phát RAM quá lớn so với nhu cầu không cải thiện hiệu năng Redis, nhưng có thể làm tăng chi phí fork() do page table của vùng nhớ đã cấp phát lớn hơn..
`SLOWLOG GET` để tìm command chậm — nhưng nhớ rằng nó chỉ ghi thời gian thực thi, không ghi thời gian chờ hay các việc ngoài vòng lặp command như fork. Vì vậy một GET chờ 800ms trong queue nhưng thực thi 200µs sẽ không xuất hiện trong SLOWLOG.
Command timeout + connection pool timeout ở tầng client (50-100ms) để tránh request xếp hàng vô hạn khi Redis tạm nghẽn.
Multi-threaded I/O (io-threads, Redis 6.0+) nếu nghẽn thật sự đến từ network I/O ở QPS cao, không phải từ fork.
3. Những nguyên nhân khác cũng gây ra hiện tượng "UP nhưng chậm"
fork()/BGSAVE chỉ là một trong nhiều nguyên nhân có chung đặc điểm: có thể làm tăng độ trễ mà không khiến tiến trình Redis chết, nên các alert chỉ dựa trên redis_up, CPU hay RAM có thể không phát hiện được. Một số nguyên nhân phổ biến khác:
- Big key bị DEL hoặc quét toàn bộ. DEL trên key có hàng trăm nghìn field là thao tác đồng bộ và có thể chặn main thread cho đến khi hoàn tất việc giải phóng bộ nhớ.
Fix: dùng UNLINK thay DEL để giải phóng bất đồng bộ, dùng SCAN/HSCAN/SSCAN thay vì KEYS/HGETALL trên tập dữ liệu lớn.
- Expire cycle dồn cục. Redis chủ động kiểm tra và xoá các key hết hạn. Nếu hàng loạt key có cùng thời điểm hết hạn (ví dụ TTL cố định và được set cùng lúc), expire cycle có thể chiếm đáng kể thời gian của main thread.
Fix: thêm jitter ngẫu nhiên vào TTL để phân tán thời điểm hết hạn.
- AOF rewrite tranh I/O với fsync. Với appendfsync always, mỗi write phải chờ fsync đồng bộ xuống đĩa. Với everysec, AOF rewrite vẫn có thể tạo thêm áp lực I/O và cạnh tranh với các hoạt động ghi đĩa khác.
Fix: production thường ưu tiên everysec thay vì always, đồng thời cân nhắc no-appendfsync-on-rewrite yes tùy yêu cầu về durability và latency.
- Swap do thiếu RAM. Khi hệ thống thiếu RAM và Redis bị swap, việc truy cập các memory page đã bị đẩy ra đĩa có thể làm latency tăng mạnh.
Fix: theo dõi used_memory so với RAM thực tế, đặt maxmemory thấp hơn RAM khả dụng và hạn chế swap trên host.
- Blocking command chạy nhầm trên production. KEYS *, FLUSHALL và SORT trên dataset lớn có thể chiếm main thread trong thời gian đáng kể.
Fix: hạn chế các command nguy hiểm bằng ACL hoặc rename-command, và ưu tiên SCAN trong tool/script nội bộ.
- Eviction storm khi chạm maxmemory. Khi Redis đạt maxmemory, các write có thể phải thực hiện eviction trước khi tiếp tục. Nếu eviction xảy ra liên tục với tốc độ cao, latency của write có thể tăng đáng kể.
Fix: theo dõi evicted_keys trong INFO stats, điều chỉnh maxmemory và maxmemory-policy phù hợp với workload trước khi thường xuyên chạm ngưỡng.
Điểm chung của các nguyên nhân này là: Redis vẫn có thể ở trạng thái UP trong khi latency tăng mạnh, và CPU/RAM tổng cũng có thể không tăng đủ rõ để kích hoạt các alert dựa trên threshold thông thường.
4. Ví dụ thực tế: tái hiện trên Redis thật
Để kiểm chứng thực tế, các số liệu và ảnh chụp dưới đây được đo trực tiếp trên Redis 7 chạy trong một Docker container cô lập. Dataset gồm khoảng 950.000–1.000.000 key (~800MB), cùng một hash 2 triệu field để mô phỏng big key.
`KEYS *` chặn thật, `SLOWLOG` ghi lại thật
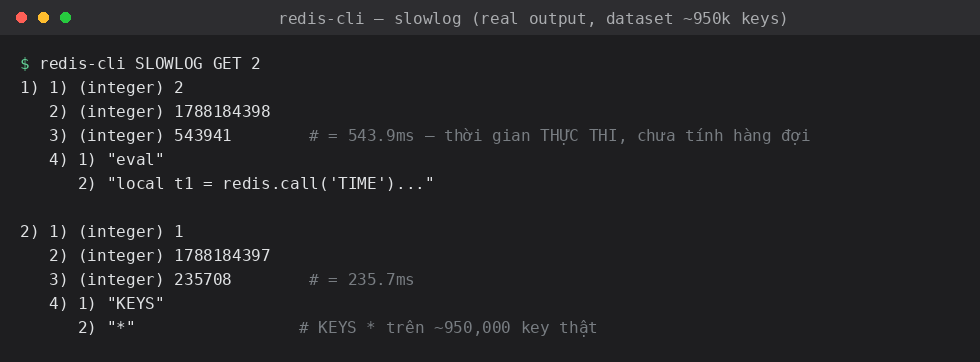
Hai lần chạy KEYS * trên ~950k key mất 235.7ms và 543.9ms thời gian thực thi trên Redis main thread. Trong khoảng thời gian đó, các command khác phải xếp hàng chờ, nên nếu nhiều request đồng thời truy cập Redis thì latency của endpoint có thể vượt SLA p99 200ms.
`LATENCY DOCTOR` tự chẩn đoán đúng nguyên nhân

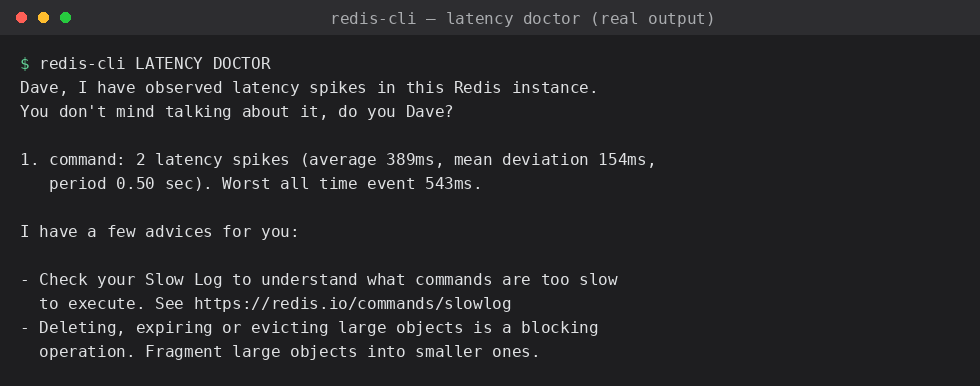
Không cần đoán mò — LATENCY DOCTOR phân tích các latency event mà Redis đã ghi nhận, thống kê tần suất, độ trễ và đưa ra nguyên nhân khả dĩ cùng khuyến nghị.
`fork()` nhanh hay chậm phụ thuộc rất nhiều vào host

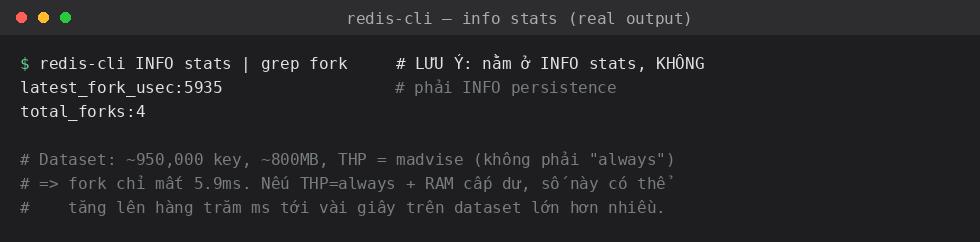
Trên máy demo này, fork chỉ mất 5.9ms cho ~800MB dữ liệu — gần như vô hình. Lý do: THP đang ở chế độ madvise, không phải always. Đây cũng là lý do nhiều team đọc xong cảnh báo về fork latency, tự kiểm tra trên dev/staging rồi kết luận "không có vấn đề gì" — vì THP, tỷ lệ RAM cấp dư so với dataset, và kích thước dataset thực tế mới là biến số quyết định, không phải bản thân việc gọi BGSAVE.
`DEL` vs `UNLINK`: chênh lệch thật, không phải lý thuyết suông

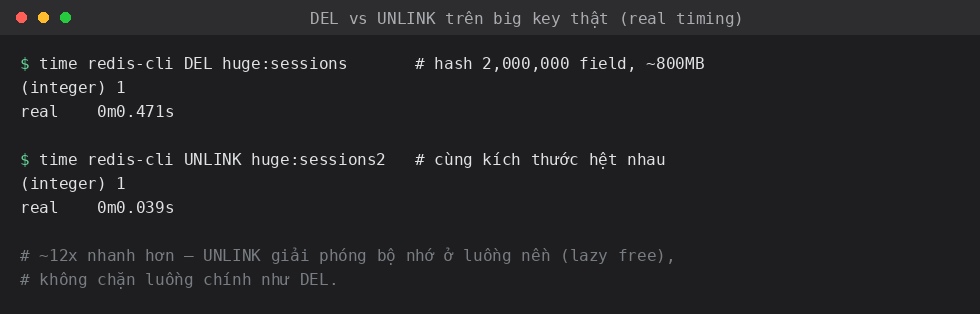
Cùng một key 2 triệu field, DELđồng bộ mất 471ms, UNLINKchỉ 39ms — chênh khoảng 12 lần. Trên production, đây có thể là khoảng cách giữa việc request vượt SLA hoặc timeout và việc người dùng hầu như không cảm nhận được độ trễ..
Code thật: client timeout hoạt động đúng — và một gotcha gặp phải khi test
Node.js (ioredis) — commandTimeouthoạt động đúng như tài liệu ngay từ lần thử đầu tiên:
const redis = new Redis({ host: "prod-redis-01", port: 6379, commandTimeout: 100, // ms — cắt request nếu Redis không phản hồi kịp});
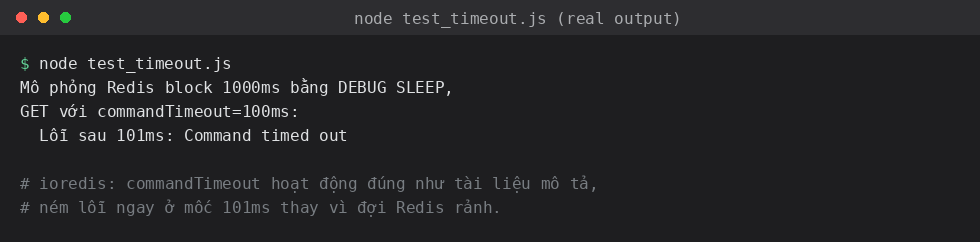
Python (redis-py 8.1.0) — đây là phần đáng chú ý nhất: cấu hình nhìn có vẻ đủ theo tài liệu lại không hoạt động đúng khi test thật bằng cách giả lập Redis bị block (DEBUG SLEEP):

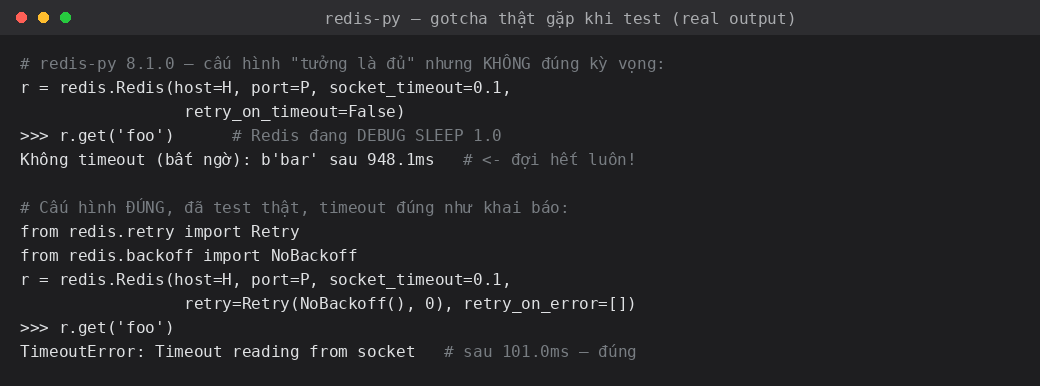
Trên redis-py 8.1.0, khi thử nghiệm bằng DEBUG SLEEP, việc chỉ cấu hình socket_timeout và retry_on_timeout=False chưa tạo ra hành vi fail-fast như mong đợi. Trong môi trường test này, client chỉ cắt request đúng mốc 100ms sau khi khai báo thêm retry=Retry(NoBackoff(), 0) và retry_on_error=[]
- Đừng tin cấu hình timeout chỉ vì đã đọc tài liệu — luôn giả lập một lần block thật (DEBUG SLEEP trên môi trường test, không phải production) để xác nhận client của bạn có thật sự cắt request đúng thời gian đã khai báo hay không, trước khi mang config đó lên production.
5. Alert theo uptime có giải quyết được vấn đề này không?
Không hoàn toàn. Uptime và CPU tổng giúp phát hiện Redis chết hẳn, nhưng không giúp phát hiện Redis đang bị block tạm thời — vốn là nguyên nhân phổ biến hơn nhiều trong thực tế production.
Muốn phát hiện đúng, cần theo dõi trực tiếp các chỉ số phản ánh việc luồng chính có đang bị chiếm dụng hay không: latest_fork_usec, rdb_bgsave_in_progress, độ trễ từ --latency-history, thay vì chỉ dừng ở PING hay CPU/RAM tổng.
Quy tắc quan trọng
Đừng hỏi: Redis có UP không? Hãy hỏi: Redis có đang bị block không?
Kết luận
Redis "UP" không đồng nghĩa với Redis "khỏe". Đây không chỉ là vấn đề của riêng Redis — mà phản ánh một sai lầm phổ biến trong cách team thiết kế monitoring: nhầm lẫn giữa process còn sống và hệ thống đang phản hồi đúng tốc độ. Dashboard vẫn xanh cho đến khi traffic đủ lớn để lộ ra khoảng trống đó — lúc đó, thêm CPU hay RAM cũng không cứu được latency.
Tài liệu tham khảo
Redis latency monitoring (LATENCY DOCTOR/HISTORY) — Redis official docs
Performance Tuning Best Practices — Redis official docs
How to Use LATENCY DOCTOR in Redis for Automated Diagnosis — OneUptime
How to Troubleshoot Redis Intermittent Latency Spikes — OneUptime